Suche nach Bedeutung: was ein Vektor ist, wo Textsuche aufhört und wie sie sehen lernt
Was ein Vektor ist, wie Textsuche nach Bedeutung auf einem gewöhnlichen Prozessor funktioniert, wo sie aufhört und wie ein Modell sehen und hören lernt.
Montag. Ein Rohr platzt, ein Schlafzimmer steht unter Wasser, und am Abend hat der Auftrag seine Spur auf dem gemeinsamen Laufwerk hinterlassen: ein Bericht, eine Sprachnotiz, Fotos, ein gescannter Lieferschein.
Drei Wochen später will jemand nur eines wissen: Zeig mir alles zur Schlafzimmerdecke. Eine Suche nach Wörtern findet den Bericht, weil im Bericht die Wörter stehen. Im Foto der Decke steht kein einziges Wort.

Dieser Artikel handelt von dem, was diese Lücke schließt: Vektoren. Was sie sind, wie Suche nach Bedeutung auf einem gewöhnlichen Prozessor funktioniert, wo sie aufhört und wie ein Modell lernt, ein Bild anzusehen und einer Aufnahme zuzuhören.
Die Firma Hollowmere Restoration, ihre Leute, ihre Aufträge und die Dateien auf ihrem Laufwerk sind erfunden. Die Modelle und jedes hier genannte Ergebnis sind echt: die Antworten des Workspaces am 22. Oktober 2026, auf einer Maschine. Die Bilder stammen aus einem kurzen Film, den wir zu diesem Artikel gemacht haben; die Fotos darin sind generiert und zeigen keine echte Person, keinen echten Ort und kein echtes Produkt.
Was ein Vektor ist
Ein Vektor ist eine Liste von Zahlen, die für die Bedeutung von etwas steht. Ein Modell liest einen Satz und schreibt diese Zahlen auf.
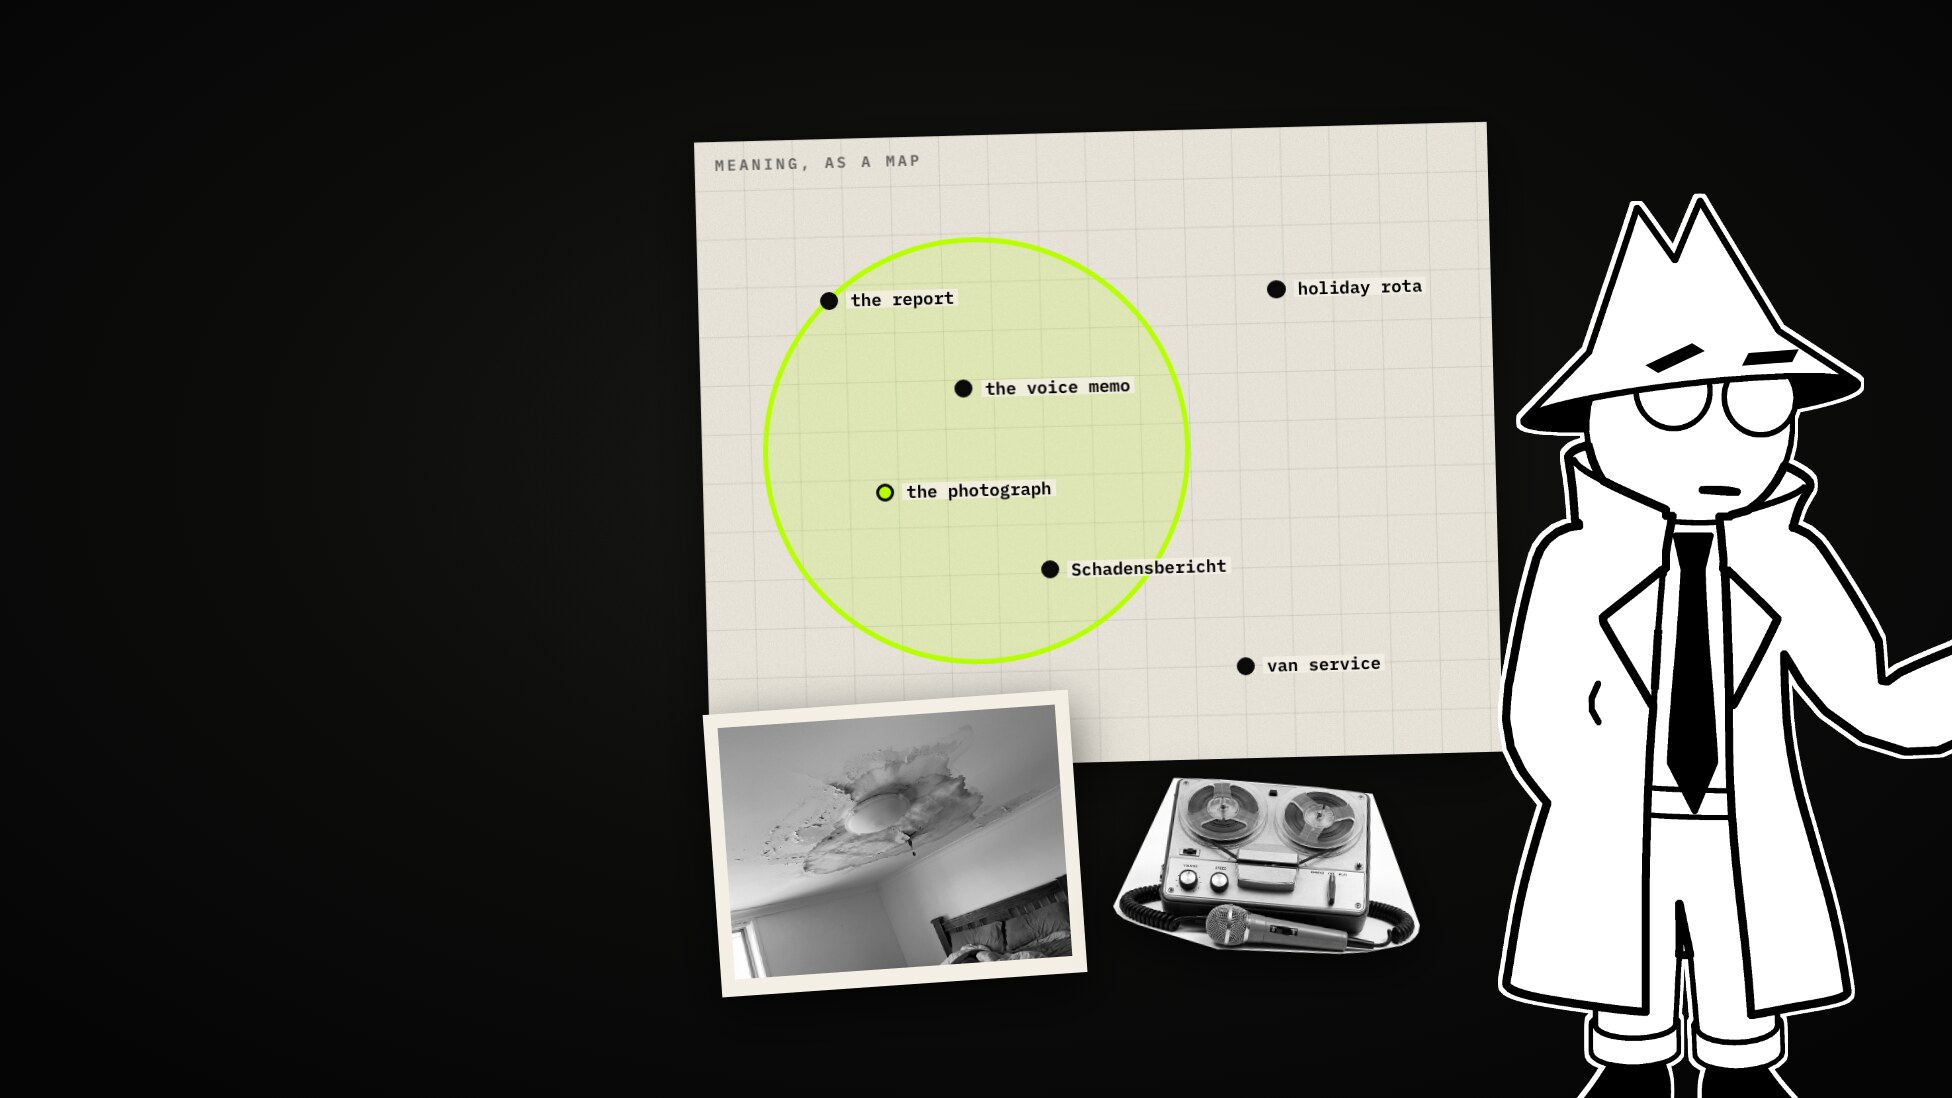
Nimmt man nur zwei Zahlen, ist jeder Satz ein Punkt auf einer Karte. Sätze, die dasselbe bedeuten, liegen nah beieinander, auch wenn sie kein Wort teilen: „a burst pipe“ und Rohrbruch bekommen fast dieselben zwei Zahlen, „holiday rota“ (Urlaubsplan) ganz andere.

Zum Suchen setzt man die Frage auf dieselbe Karte und sieht nach, was am nächsten liegt. Nähe wird als Winkel zwischen zwei Pfeilen aus der Mitte gemessen: Je kleiner der Winkel, desto näher die Bedeutung. Das ist die Kosinus-Ähnlichkeit, und die vergleicht Classifyre.

Echte Modelle nehmen statt zwei Hunderte oder Tausende Zahlen, aber die Idee ist dieselbe.
Textsuche auf dem Prozessor
Die einfachste Einrichtung läuft auf jedem Computer, und so arbeitet Classifyre ab Werk:
- Jede Datei wird als Text gelesen: Word-Dateien, Tabellen und Mails, wie sie sind, Bilder über ein Programm, das nach Buchstaben sucht (OCR), Aufnahmen über eine Transkription.
- Der Text wird in Abschnitte von bis zu 1.200 Zeichen geschnitten, die sich jeweils um 200 überlappen.
- Ein kleines eingebautes Modell macht aus jedem Abschnitt 384 Zahlen, auf dem Prozessor der Maschine, auf der Classifyre läuft. Nichts verlässt sie.
Das geht schnell. Auf diesem Laufwerk schrieb das Modell 716 Textstücke in 12 Sekunden auf, und eine Frage dauerte 3 bis 4 Tausendstelsekunden.

Fragt man „water coming through the bedroom ceiling“, stehen die vor Ort aufgenommene Sprachnotiz und der Besichtigungsbericht vorn: Beide enthalten die Wörter. Für Text ist das ein guter Anfang.
Wo sie aufhört
Das Foto
Ein Bild wird nur über ein Programm zu Text, das nach Buchstaben sucht, und ein Fleck an der Decke hat keine. Nichts kommt auf die Karte, also bringt keine Frage es je hervor. Auf diesem Laufwerk steht in drei der fünf Fotos nichts geschrieben: die Decke, der Schimmel in der Ecke hinter dem Kleiderschrank, das Rohr unter der Spüle.

Die Sprache
Das kleine Modell hat Englisch gelernt. Auf Deutsch gefragt, „Schimmel im Schlafzimmer hinter dem Schrank“, setzte es die deutsche Sprachnotiz an die erste Stelle. An zweiter stand ein Satz aus den Beispieltexten des Laufwerks über zwei Menschen, die auf einem Sofa schlafen: Ein Mann und eine Frau schlafen auf dem Sofa. Er teilt Buchstaben mit Schlafzimmer, nicht die Bedeutung. Der englische Besichtigungsbericht, der genau diesen Schimmel beschreibt, war nicht unter den ersten zwölf.

Wie ein Modell sehen lernt
Ein Modell, das Bilder liest, schließt die erste Lücke. Es zerlegt ein Bild in kleine Quadrate, liest sie so, wie ein Textmodell Wörter liest, und schreibt dieselbe Art von Zahlenliste, auf dieselbe Karte wie den Text. Das Foto einer fleckigen Decke landet neben dem Satz „Das Wasser kam durch die Decke“.

Das lernt es an Bildern mit ihren Bildunterschriften: Jedes Bild wird zu seiner eigenen Unterschrift hingezogen und von allen anderen weggeschoben.

Ein größeres Modell dieser Art schließt auch die zweite Lücke. Es hat viele Sprachen gelernt, also landet eine deutsche Frage neben einer englischen Antwort. Allein nach Bedeutung gefragt, gab es auf die deutsche Schimmel-Frage als erste zwei Texte englische Dateien über denselben Kleiderschrank zurück: die Messwerte („wall behind wardrobe 27.4“) und das Rundgang-Video („this is the corner behind the wardrobe, where the mould is“). Der Sofa-Satz war nicht unter den ersten vierzig.
Ton, wenn es nicht auf die Worte ankommt
Ton funktioniert genauso. Eine Aufnahme wird zu einem Bild ihres Klangs, in Scheiben von Sekundenbruchteilen geschnitten, und jede Scheibe wird wie ein Wort gelesen. Classifyre bettet eine Aufnahme in Stücken von zehn Sekunden ein, damit ein Geräusch unter einer Stimme ein Stück, und einen Vektor, fast für sich bekommt.
Das zählt, wenn es nicht auf die Worte ankommt. Um zwei Uhr nachts hinterlässt eine Nachbarin eine Nachricht auf dem Bürotelefon: Hello. It’s flat one at 14 Alder Row. Sorry it’s so late. It’s started again. Just listen. Dann fünfzehn Sekunden laufendes Wasser in ihrem Flur und Somebody come round in the morning, please.
Ein Transkript hat ihre Worte und sonst nichts. Nach „water running“ gefragt, brachte die Textsuche ihre Nachricht nicht unter die ersten zwölf. Das Wasser steckt nur im Ton.

Es gab eine zweite Nachricht, vom Hausmeister: Can you hear that? über einem Rauchmelder. Die fiel nicht auf. Für das Modell klingt ein Alarm im Treppenhaus ähnlich wie ein schreiendes Baby und ein Hahn, und beide waren unter den Beispielgeräuschen des Laufwerks; seine Nachricht stand weit unten. Eindeutige Geräusche werden gefunden; Geräusche, die anderen im selben Bestand ähneln, werden zwischen diesen eingeordnet.
In Classifyre
Das ist eine Einstellung, kein Projekt. Unter Harness AI → Embedding:
- Modell. Ab Werk steht es auf Local inference: das eingebaute Modell auf dem Prozessor. Für Bilder und Ton wählt man Remote provider und einen gespeicherten KI-Anbieter, dessen Modell sie nimmt. Die Karte darunter sagt, was das Modell außerdem nimmt (Bilder, Ton).
- Was eingebettet wird. Text wird immer eingebettet. Schalten Sie Pictures ein, und Sound, wenn Aufnahmen auch als Ton eingebettet werden sollen.
- Scan. Der nächste Scan einer Quelle liest jedes Bild und jede Aufnahme noch einmal, und sie landen auf der Karte neben dem Text.
Ein Modellwechsel bettet alles von Grund auf neu ein, und der Wechsel zurück zu einem Modell, das nur Text liest, löscht, was für Bilder und Ton gespeichert war. Die vollständige Referenz steht in der Dokumentation: Settings → Embeddings.

Nach dem Scan hielt das Laufwerk 802 Vektoren, 77 davon Bilder und Tonstücke. Dieselben Fragen, vorher und nachher:
| Frage | Eingebautes Textmodell, erste Ergebnisse | Modell, das Bilder und Ton liest, erste Ergebnisse |
|---|---|---|
| water coming through the bedroom ceiling | die Sprachnotiz, der Bericht | das Deckenfoto, die Sprachnotiz, der Bericht |
| black mould in the corner of a room | der Besichtigungsbericht | das Foto der Ecke |
| a leaking pipe under a kitchen sink | eine Notiz zu einem Boilerleck | das Rohrfoto |
| Schimmel im Schlafzimmer hinter dem Schrank | die deutsche Notiz, dann das Sofa | das Foto der Ecke, die deutsche Notiz, der Bericht |
| Wasserschaden an der Decke im Schlafzimmer | die deutsche Notiz | das Deckenfoto, der deutsche Bericht |
| water running | zwei Sätze mit den Wörtern; ihre Nachricht nicht unter den ersten zwölf | dieselben zwei Sätze, dann ihre Nachricht (allein nach Bedeutung die erste) |
In keinem der drei Fotos steht ein Wort, und in ihrer Nachricht steht keins der Wörter, mit denen sie gefunden wurde.


Die Bildschirme sind Screenshots des laufenden Workspaces. Die lindgrünen Rahmen und Etiketten darauf sind von uns, ebenso die schwarzen Felder über den zwei Zeilen, die das Modell des Anbieters nennen: Es kommt darauf an, was ein solches Modell tut, nicht welches es ist.
Was ein Vektor nicht tut
- Er sagt, dass zwei Dinge sich ähneln, nicht warum. Ein Foto nahe an Ihrer Frage ist eine Spur, keine Antwort.
- Bei genauen Dingen ist er ungenau, etwa bei einer Auftragsnummer oder einem Namen. Allein nach Bedeutung gefragt, „HR-2242“, gab das Laufwerk drei unbeteiligte Bilder und eine Sprachnachricht vor der Notiz zu Auftrag HR-2242 zurück. Ein Name verhielt sich genauso. Deshalb ordnet das Suchfeld von Classifyre nach Bedeutung, nach den Wörtern in den Abschnitten und nach Dateinamen zugleich und führt die drei Listen zusammen.
| „HR-2242“ | Erstes Ergebnis | Platz der Auftragsnotiz |
|---|---|---|
| Nur Bedeutung | ein unbeteiligtes Bild | 5. |
| Das Suchfeld (Bedeutung und Wörter) | die Auftragsnotiz | 1. |

- Ein entferntes Modell sieht, was es einbettet. Mit dem Modell eines Anbieters gehen der Text und, sobald sie eingeschaltet sind, die Bilder und Aufnahmen an diesen Anbieter. Das eingebaute Modell behält alles auf der Maschine.
Eine Faustregel
Fangen Sie mit Text an, auf dem eigenen Prozessor. Nehmen Sie ein Modell dazu, das Bilder und Ton liest, wenn Ihre Antworten darin stecken. Und prüfen Sie die ersten Ergebnisse mit eigenen Augen, an Fragen, deren Antworten Sie kennen.
Wie man es einrichtet: docs.classifyre.com/settings/embeddings.
Mehr aus dem Blog
Dasselbe oder nicht? Wie Dublettenabgleich die Belege gewichtet
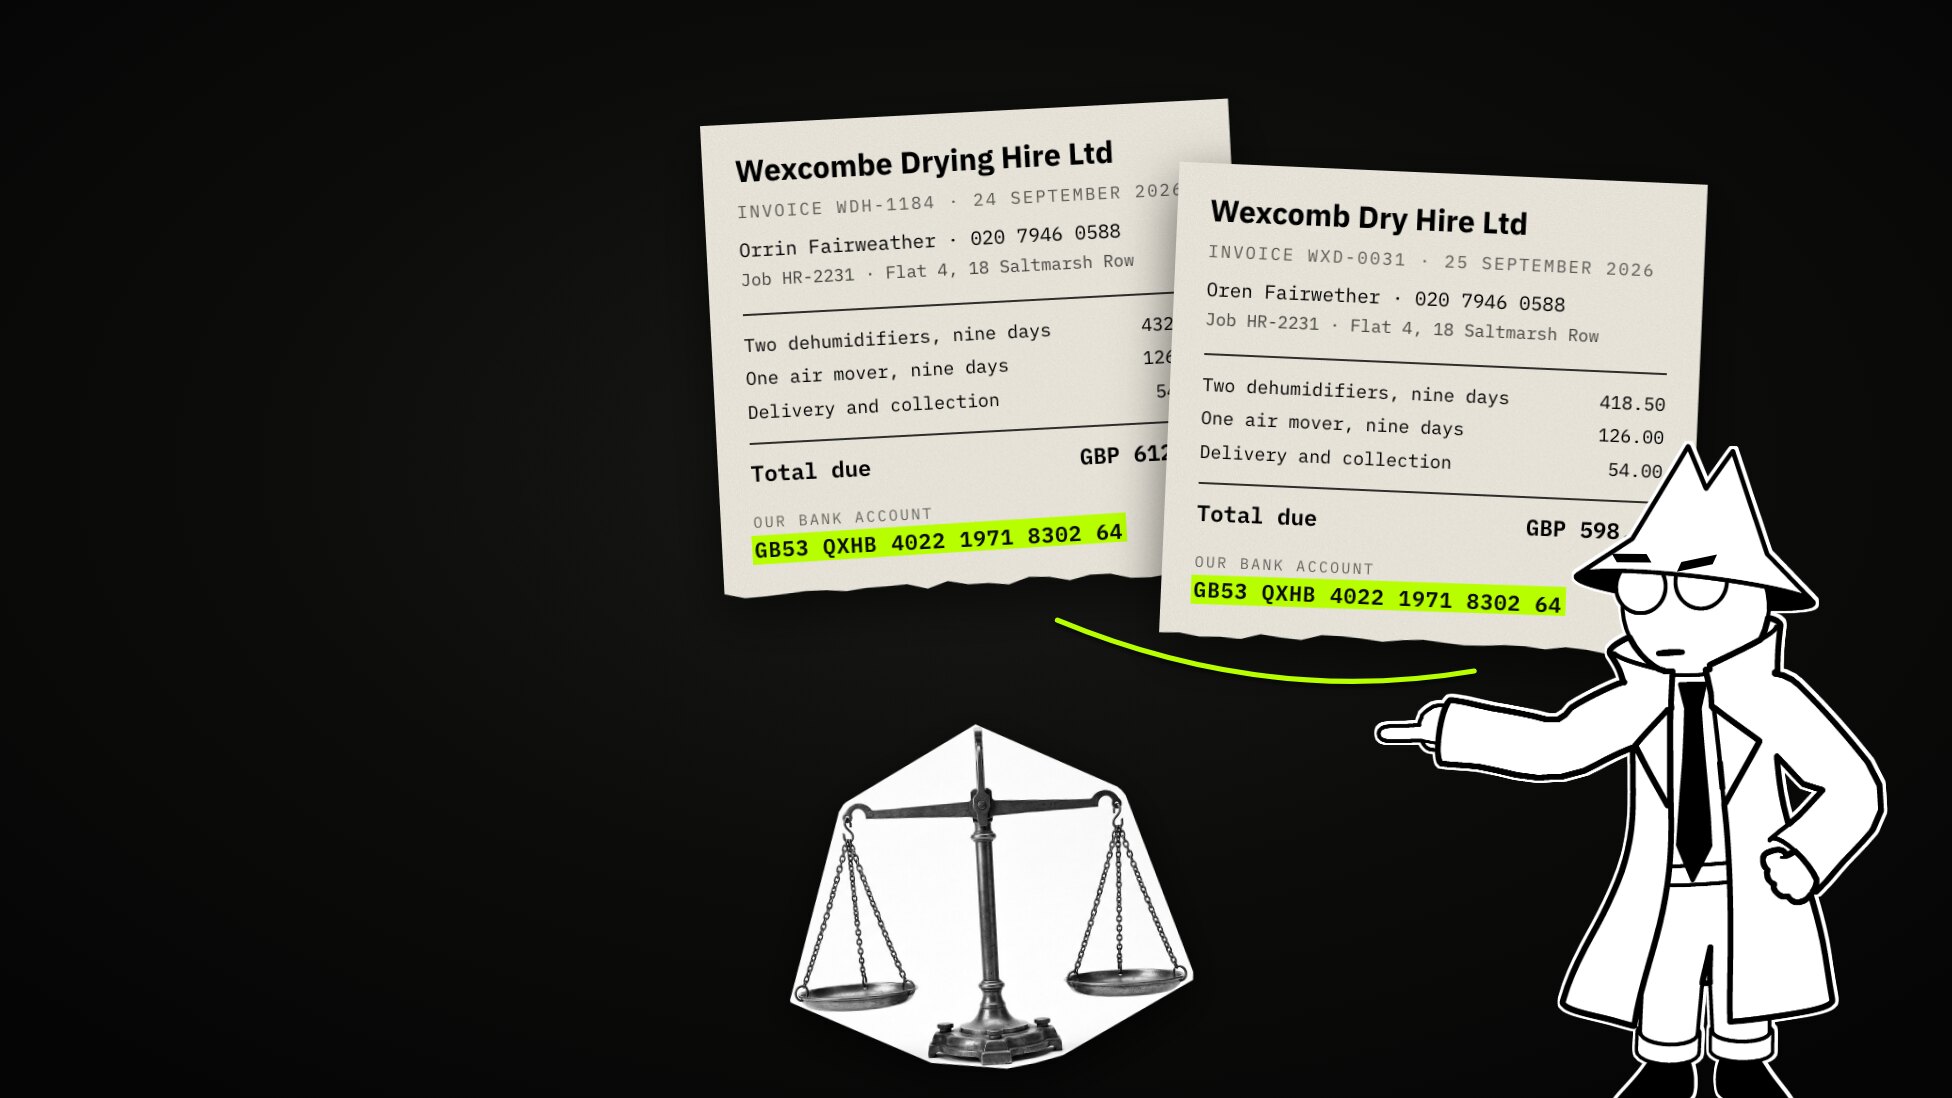
Eine Erklärung in einfachen Worten zum Dublettenabgleich. Wie zwei Dokumente Wert für Wert verglichen werden, was ein Gewicht ist und wie die Punktzahl entsteht, was die beiden Grenzen entscheiden, wie man das Rauschen Schritt für Schritt wegstellt und was mit einem Treffer geschieht, der zählt, gezeigt am Laufwerk einer erfundenen Firma.
Ein Blick: Entscheidungsmodelle, System One und was fünf davon mit fünfzig Nachrichten gemacht haben
Ein Entscheidungsmodell schreibt nicht. Man gibt ihm einen Text und eine Liste von Fragen, und es beantwortet jede mit einer Wahrscheinlichkeit. Was das ist, woher der Name System One kommt, warum es plötzlich so viele gibt und was fünf echte Modelle mit fünfzig Nachrichten an einen Fahrradladen gemacht haben, den es nicht gibt.