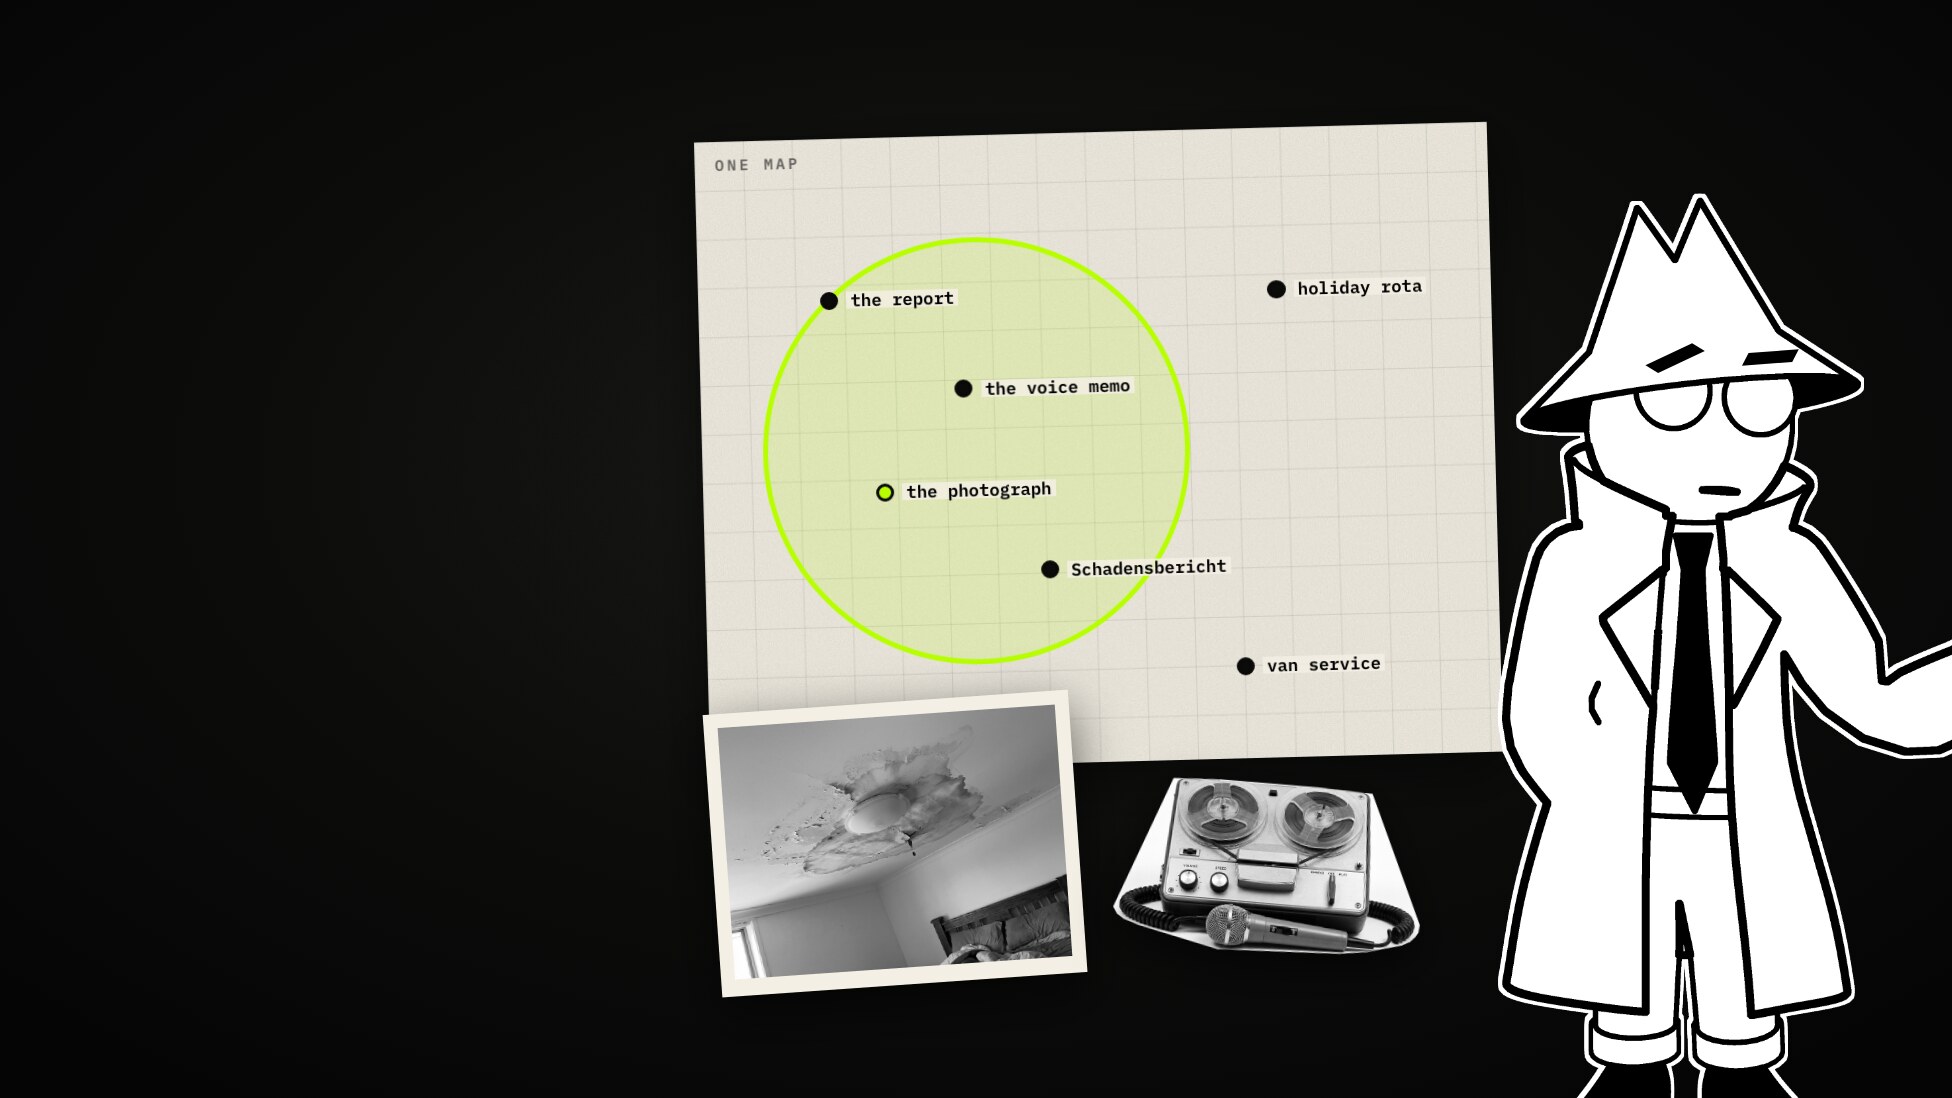
Eine Karte
EmbeddingGemma 2 setzt Text, Bilder, Ton und Video in einen gemeinsamen Vektorraum und läuft ohne Grafikkarte. Wie es funktioniert, und was wir auf vier Prozessorkernen gemessen haben.
Montag. Ein Rohr platzt, ein Schlafzimmer steht unter Wasser, und am Abend hat der Auftrag seine Spur auf dem gemeinsamen Laufwerk hinterlassen: ein Bericht, eine Sprachnotiz, Fotos, ein gescannter Lieferschein, ein Video vom Gang durch die Wohnung.
Drei Wochen später will jemand nur eines wissen: Zeig mir alles zur Schlafzimmerdecke. Die Suche findet den Bericht, weil im Bericht die Wörter stehen. Im Foto der Decke steht kein einziges Wort.

Am 6. Oktober 2026 hat Google DeepMind ein Modell veröffentlicht, das diese Lücke schließen soll: EmbeddingGemma 2. Dieser Artikel erklärt, was es ist und wie es funktioniert, und berichtet dann, was passiert ist, als wir es auf vier Prozessorkernen laufen ließen.
Die Firma Hollowmere Restoration, ihre Leute, ihre Aufträge und alle 38 Dateien auf ihrem Laufwerk sind erfunden. Die Modelle und jede hier genannte Zahl sind echt, gemessen am 11. Oktober 2026 auf einer Maschine. Die Bilder stammen aus einem kurzen Film, den wir zu diesem Artikel gemacht haben; die Fotos darin sind generiert und zeigen keine echte Person, keinen echten Ort und kein echtes Produkt. Die Beschriftungen im Film sind englisch.
Was ein Embedding ist
Ein Embedding ist eine Liste von Zahlen, die für die Bedeutung von etwas steht. Am einfachsten stellt man es sich als Ort auf einer Karte vor. Ein Modell liest einen Satz und setzt ihn irgendwohin; Sätze, die dasselbe bedeuten, landen nah beieinander, auch wenn sie kein Wort gemeinsam haben. „A burst pipe“ und „Rohrbruch“ sind Nachbarn.
Suchen ist dann einfach. Man setzt die Frage auf dieselbe Karte und sieht nach, was in der Nähe liegt.

Wie man Bilder und Ton bisher durchsucht hat
Jahrelang war diese Karte nur für Text da, also wurde alles andere zuerst in Text verwandelt. Ein Bild ging durch ein Programm, das nach Buchstaben sucht (OCR). Eine Aufnahme ging durch eine Transkription. Dann wurden die Wörter eingebettet.
Das funktioniert, und so arbeitet heute die meiste Dokumentensuche. Es hat zwei Preise. Es sind drei Maschinen hintereinander, jede mit ihren eigenen Fehlern. Und man findet nur, was eine von ihnen aufgeschrieben hat. Ein Fleck an der Decke schreibt nichts auf.

Dazwischen gab es Zwischenschritte. CLIP (2021) trainierte zwei Modelle nebeneinander, eines für Bilder und eines für Bildunterschriften, sodass ein Foto und seine Unterschrift am selben Ort landen. Das machte die Suche von Text nach Bild gut, für ein Paar von Formaten. ImageBind (2023) richtete sechs Formate an Bildern aus. Der neueste Ansatz ist ein Modell, das jedes Format selbst liest. Googles Gemini Embedding 2 arbeitet so, aber nur als API. EmbeddingGemma 2 ist dieselbe Idee mit offenen Gewichten, in einer Größe, die man selbst betreiben kann.
EmbeddingGemma 2
| Veröffentlicht | 6. Oktober 2026, Google DeepMind |
| Lizenz | Apache 2.0, offene Gewichte |
| Größe | 740 Millionen Parameter: 270 Mio. für Text, 170 Mio. für den Bild-Encoder, 300 Mio. für den Audio-Encoder |
| Liest | Text und Code, Bilder, Video, Audio und Mischungen daraus |
| Liefert | Einen Vektor aus 768 Zahlen, egal was hineinkam |
| Fenster | 8.192 Tokens: etwa 29 Bilder, 58 Videobilder oder fünfeinhalb Minuten Ton |
Ein Modell, das Text liest, kann keine Pixel lesen. Deshalb stehen zwei kleine Encoder davor. Der eine macht aus einem Bild Tokens, der andere tut dasselbe für Ton. Von da an ist alles eine Reihe von Tokens, durch ein gemeinsames Rückgrat. Standardmäßig kostet ein Foto 280 Tokens, ein Videobild 140 und eine Sekunde Ton 25.
Am Ende mittelt das Modell alles zu 768 Zahlen: ein Ort auf der Karte.

Einen technischen Bericht zu diesem Modell selbst haben wir nicht gefunden. Zu seinem größeren Geschwister hinter der API, Gemini Embedding 2, gibt es ein Paper, und das beschreibt kontrastives Training in großem Maßstab: Man zeigt dem Modell Paare, die zusammengehören, ein Foto und seine Unterschrift, einen Clip und seine Abschrift, und trainiert es, jedes Paar zusammenzuziehen und alles andere wegzuschieben.
Zwei Entwurfsentscheidungen, die im Betrieb zählen
Kleinere Vektoren. Das Modell ist so trainiert, dass die ersten 512, 256 oder 128 Zahlen eines Vektors für sich als Vektor funktionieren (Matryoshka Representation Learning, nach den russischen Puppen). Bei 256 Zahlen speichert man ein Drittel. Der Haken steht in Googles eigener Tabelle:
| Behaltene Zahlen | Text (MTEB multilingual) | Bilder, Video, Dokumente (MMEB v2) |
|---|---|---|
| 768 | 61,36 | 59,01 |
| 256 | 60,41 | 56,24 |
| 128 | 57,89 | 45,65 |
Auf 128 gekürzt verliert Text dreieinhalb Punkte; Bilder und Video verlieren dreizehn.

Optionale Encoder. Bild- und Audio-Encoder kann man weglassen. Text allein sind 270 Millionen Parameter, und er landet auf derselben Karte. Man kann seine Fotos also einmal mit dem ganzen Modell indexieren und mit dem kleinen durchsuchen.

Betrieb auf einem Prozessor
Google sagt, das Modell sei für Laptops und Telefone gebaut. Wir wollten wissen, was das auf einem gewöhnlichen Serverprozessor ohne Grafikkarte bedeutet. Der Aufbau: ein Kubernetes-Cluster mit einem Knoten in Docker auf einem Apple M1 Pro, der Modell-Pod auf vier Kerne begrenzt, die auf 8 Bit quantisierten Gewichte.
Wo es heute läuft
Die erste Überraschung hatte nichts mit Tempo zu tun. Ollama ist der übliche
Weg, solche Modelle zu betreiben, und in seiner Bibliothek steht
embeddinggemma-2. In einem Linux-Container antwortete jedes Tag gleich:
Error: this model requires MLX support, but the MLX runtime is not availableAm 11. Oktober 2026 (Ollama 0.40.3) sind die Builds der Bibliothek nur für Apples MLX-Laufzeit gemacht. Ein Maintainer schrieb im Issue, Linux und Windows würden bald unterstützt. Die GGUF-Datei über Ollama zu laden half auch nicht: Das mitgelieferte llama.cpp kannte die Architektur noch nicht.
Der Server von llama.cpp selbst schon. Ein Container, die offizielle GGUF-Datei
aus ggml-org/embeddinggemma-2-GGUF und ein Endpunkt im OpenAI-Format:
containers:
  - name: llama-server
    image: ghcr.io/ggml-org/llama.cpp:server
    args:
      - --hf-repo
      - ggml-org/embeddinggemma-2-GGUF:Q8_0
      - --no-mmproj        # nur der Text-Teil; weglassen, um die Encoder zu laden
      - --embedding
      - --ctx-size
      - "8192"
      - --parallel
      - "4"
      - --threads
      - "4"
Wie schnell
| EmbeddingGemma 2, 4 Kerne | EmbeddingGemma 2, 8 Kerne | MiniLM-L6, 2 Kerne | |
|---|---|---|---|
| Eine Frage | 0,12 s | 0,11 s | 0,002 s |
| Abschnitte von 1.200 Zeichen pro Sekunde | 0,4 | 0,6 bis 0,7 | 5,9 |
MiniLM-L6 ist das kleine englische Modell, das wir bis dahin verwendet hatten (22 Millionen Parameter). Ein Abschnitt von 1.200 Zeichen sind etwa 300 Tokens.
Eine Suche ist also so schnell, dass es niemand merkt. Langsam ist der Aufbau des Index: Bei 0,4 Abschnitten pro Sekunde brauchen hunderttausend Abschnitte auf vier Kernen etwa drei Tage. Für ein Laufwerk mit ein paar tausend Dateien ist das ein Abend. Für ein Archiv ist es ein Grund, sich für das Indexieren eine Grafikkarte zu leihen und die CPU für das Suchen zu behalten.

Findet es etwas
Wir haben zehn Fragen zum Laufwerk geschrieben, jede mit den Dateien, die ein Mensch zurückbekommen möchte, und sie über dieselbe Suche mit drei Modellen gestellt.
| Modell | Richtige Datei an erster Stelle | Mittlerer reziproker Rang |
|---|---|---|
| MiniLM-L6 (384 Zahlen, auf Englisch trainiert) | 5 von 10 | 0,64 |
| EmbeddingGemma 2 auf vier Kernen | 6 von 10 | 0,78 |
| Gemini Embedding 2 über die API (768 Zahlen) | 7 von 10 | 0,83 |
Zehn Fragen sind eine Demonstration, kein Benchmark. Der deutlichste Unterschied lag nicht in den Summen. „Flooded basement after heavy rain“, auf Englisch gefragt, brachte mit beiden Google-Modellen die deutsche Notiz Kellerüberflutung an erster Stelle. MiniLM lieferte sie überhaupt nicht.

Die Prompts, die man leicht übersieht
Eine Zeile in der Modellkarte entscheidet, ob man diese Zahlen bekommt. Das Modell will wissen, auf welcher Seite einer Suche ein Text steht:
task: search result | query: water coming through the bedroom ceiling
title: none | text: Water has come through the ceiling over the bed…
Eine Bibliothek wie sentence-transformers setzt sie für einen. Ein nackter
/v1/embeddings-Endpunkt bettet ein, was als Zeichenkette ankommt. Ohne die
Prompts setzte dasselbe Modell auf denselben Abschnitten die richtige Datei
fünfmal statt sechsmal an die erste Stelle (mittlerer reziproker Rang 0,70
statt 0,78): Kurze Zeichenketten, die der Frage nur ähnlich sahen, lagen vor
dem Abschnitt, der sie beantwortet.

Das Foto selbst
Dann haben wir das ganze Modell geladen, samt Encodern, auf denselben vier Kernen, und ihm die Bilder selbst gegeben. Kein OCR, keine Bildunterschrift.
Zuerst eine Plausibilitätsprüfung: sechs Bildunterschriften gegen sechs Bilder. Jede Unterschrift erzielte ihren höchsten Wert beim eigenen Bild.

Dann ein Index mit 43 Dingen: die 35 Dateien, die Text haben, die sechs Bilder als Pixel und die zwei Sprachnotizen als Ton.
- „Water coming through the bedroom ceiling“: Das Foto kam an dritter Stelle, die gesprochene Notiz an vierter.
- „The pipe joint that failed under a sink“: Das Foto des Rohrs kam an erster Stelle.
- „Schimmel im Schlafzimmer hinter dem Schrank“, auf Deutsch gefragt: Das Foto der schimmeligen Ecke kam an vierter Stelle.
- Jede Sprachnotiz, als Ton eingebettet, lag am nächsten bei ihrer eigenen Abschrift (0,83 gegenüber 0,72 für die der anderen Notiz).

Der Preis ist Zeit. Ein Foto brauchte auf vier Kernen etwa eine Minute (53 bis 60 Sekunden), der A4-Scan fast vier Minuten, eine Notiz von 33 Sekunden 12 Sekunden. Das ist in Ordnung für ein paar hundert Bilder und aussichtslos für eine Million.
Wo wir es betrieben haben
Den Text-Teil haben wir in Classifyre laufen lassen. Es scannt eine Quelle, liest in Text, was sich lesen lässt, und indexiert den Text. Das Modell wird als OpenAI-kompatibler Endpunkt angeschlossen: eine Adresse im Cluster, kein Schlüssel, und die beiden Prompts.

Nach der Schlafzimmerdecke gefragt liefert der Arbeitsbereich zuerst die Sprachnotiz (Whisper hatte sie transkribiert), dann die Feuchtemessungen, dann den Bericht.

Was es nicht tut: Es nutzt nur die Textseite des Modells. Bilder werden nach ihren Wörtern gelesen, und die drei Fotos ohne Schrift tauchen in keinem Ergebnis auf. Das Bild selbst einzubetten, wie im Abschnitt oben, kann das Produkt nicht.
Der Test eines neuen Modells hat auch Dinge zutage gebracht, die nichts mit ihm zu tun hatten. Vier davon sind seit heute im Entwicklungszweig behoben:
- Das Leseprogramm hatte aufgehört zu lesen. Eine Version der OCR-Bibliothek vom 8. Oktober hat einen Namen entfernt, den eine andere Bibliothek importiert. Diese fing den Fehler ab, schrieb „no OCR engine found“ ins Protokoll und machte weiter, sodass jedes Bild und jeder Scan als leeres Dokument zurückkam. Das zählt jetzt als fehlgeschlagene Extraktion mit genanntem Grund, und die Version ist festgeschrieben.
- Die Transkription stürzte ab, bei jeder Audio- und Videodatei, nachdem ein Update der Medienbibliothek ein Argument entfernt hatte, das die Sprachbibliothek noch übergibt. Ebenfalls festgeschrieben.
- Ein Endpunkt ohne API-Schlüssel wurde abgelehnt, was jeden selbst betriebenen Server ausschloss. Für solche ist der Schlüssel jetzt optional.
- Für die beiden Prompts gab es keinen Platz. Sie sind jetzt Felder am Anbieter, und eine Änderung des Dokument-Prompts bettet den Arbeitsbereich neu ein.
Was es nicht tut
- Seine Werte liegen dicht beieinander. In unserem Raster erzielte das richtige Bild 0,67 bis 0,81 und ein falsches 0,51 bis 0,71. Ordnen Sie die Ergebnisse; ziehen Sie keine Grenze bei einer Zahl.
- 128 Zahlen sind für Text. Das sagt Googles Tabelle, und die Modellkarte sagt es auch.
- Beim Indexieren ist es auf einem Prozessor nicht schnell, und Bilder kosten weit mehr als Text.
- Es liest 8.192 Tokens auf einmal. Eine lange Aufnahme oder ein Video muss vorher zerschnitten werden.
- Es war fünf Tage alt, als wir es getestet haben. Die Werkzeuge holen noch auf, wie der Ollama-Fehler zeigt.
Eine Faustregel
Eine Karte schlägt drei Maschinen hintereinander. Einmal mit dem großen Modell indexieren, mit dem kleinen suchen. Und an den eigenen Dateien testen, mit Fragen, deren Antworten man kennt.
Quellen
- Google, Ankündigung von EmbeddingGemma 2, 6. Oktober 2026, und der Entwicklerleitfaden.
- Hugging Face, google/embeddinggemma-2: die Modellkarte mit der Kürzungstabelle und den Task-Prompts.
- Hugging Face, ggml-org/embeddinggemma-2-GGUF.
- Ollama, Issue 18825, „Failed to pull embeddinggemma-2:740m on linux“.
- Prompt Engineering, EmbeddingGemma 2: On-Device Multimodal RAG Made Easy, 7. Oktober 2026, dessen Reihenfolge der Erklärung wir übernommen haben.
- Shanbhogue et al., Gemini Embedding 2: A Native Multimodal Embedding Model from Gemini, 2026.
- Radford et al., CLIP, 2021; Girdhar et al., ImageBind, 2023.
Mehr aus dem Blog
Ein Blick: Entscheidungsmodelle, System One und was fünf davon mit fünfzig Nachrichten gemacht haben
Ein Entscheidungsmodell schreibt nicht. Man gibt ihm einen Text und eine Liste von Fragen, und es beantwortet jede mit einer Wahrscheinlichkeit. Was das ist, woher der Name System One kommt, warum es plötzlich so viele gibt und was fünf echte Modelle mit fünfzig Nachrichten an einen Fahrradladen gemacht haben, den es nicht gibt.
Ihr Laptop vergisst nichts: Geleakte Secrets in Screenshots, .env-Dateien und alten Notizen finden
Ein API-Schlüssel im Screenshot, eine .env-Datei im aufgegebenen Nebenprojekt, eine Textnotiz voller Passwörter. Schritt für Schritt alle geleakten Secrets auf dem eigenen Laptop finden, mit einem Docker-Befehl, nur lesend, ohne dass etwas das Gerät verlässt.
Unseren schönsten Screen gelöscht: Von Fingerprints zur Near-Duplicate-Prüfung
Warum wir den Fingerprint-Ähnlichkeitsgraphen durch eine Duplicate-Review-Queue ersetzt haben — was uns der Canvas gekostet hat, was sich für Fälle geändert hat und was die neuen Zahlen wirklich bedeuten.