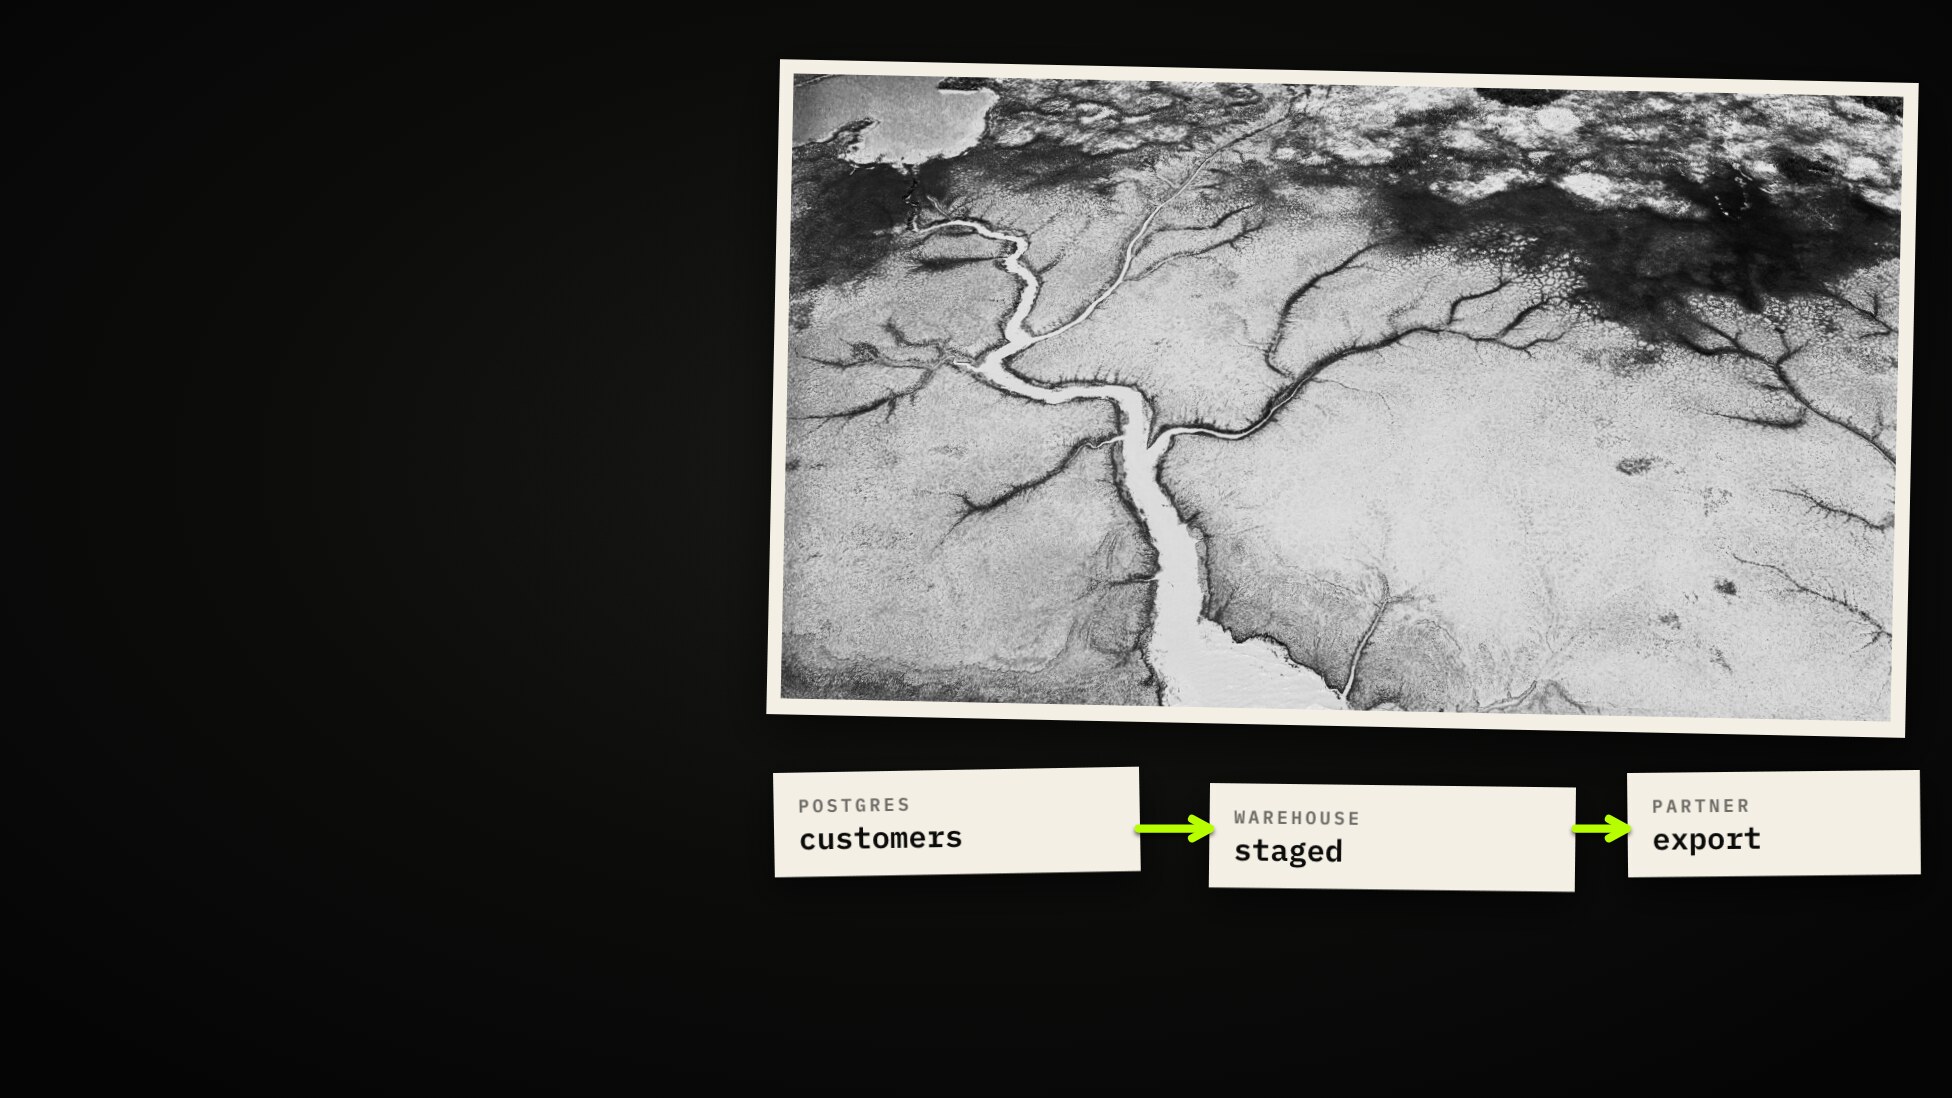
Den Daten folgen: Was Lineage ist und wie man sie liest
Woher ein Wert kommt, was bricht, wenn man ihn ändert, und woran man einen Pfeil erkennt, dem man trauen kann.
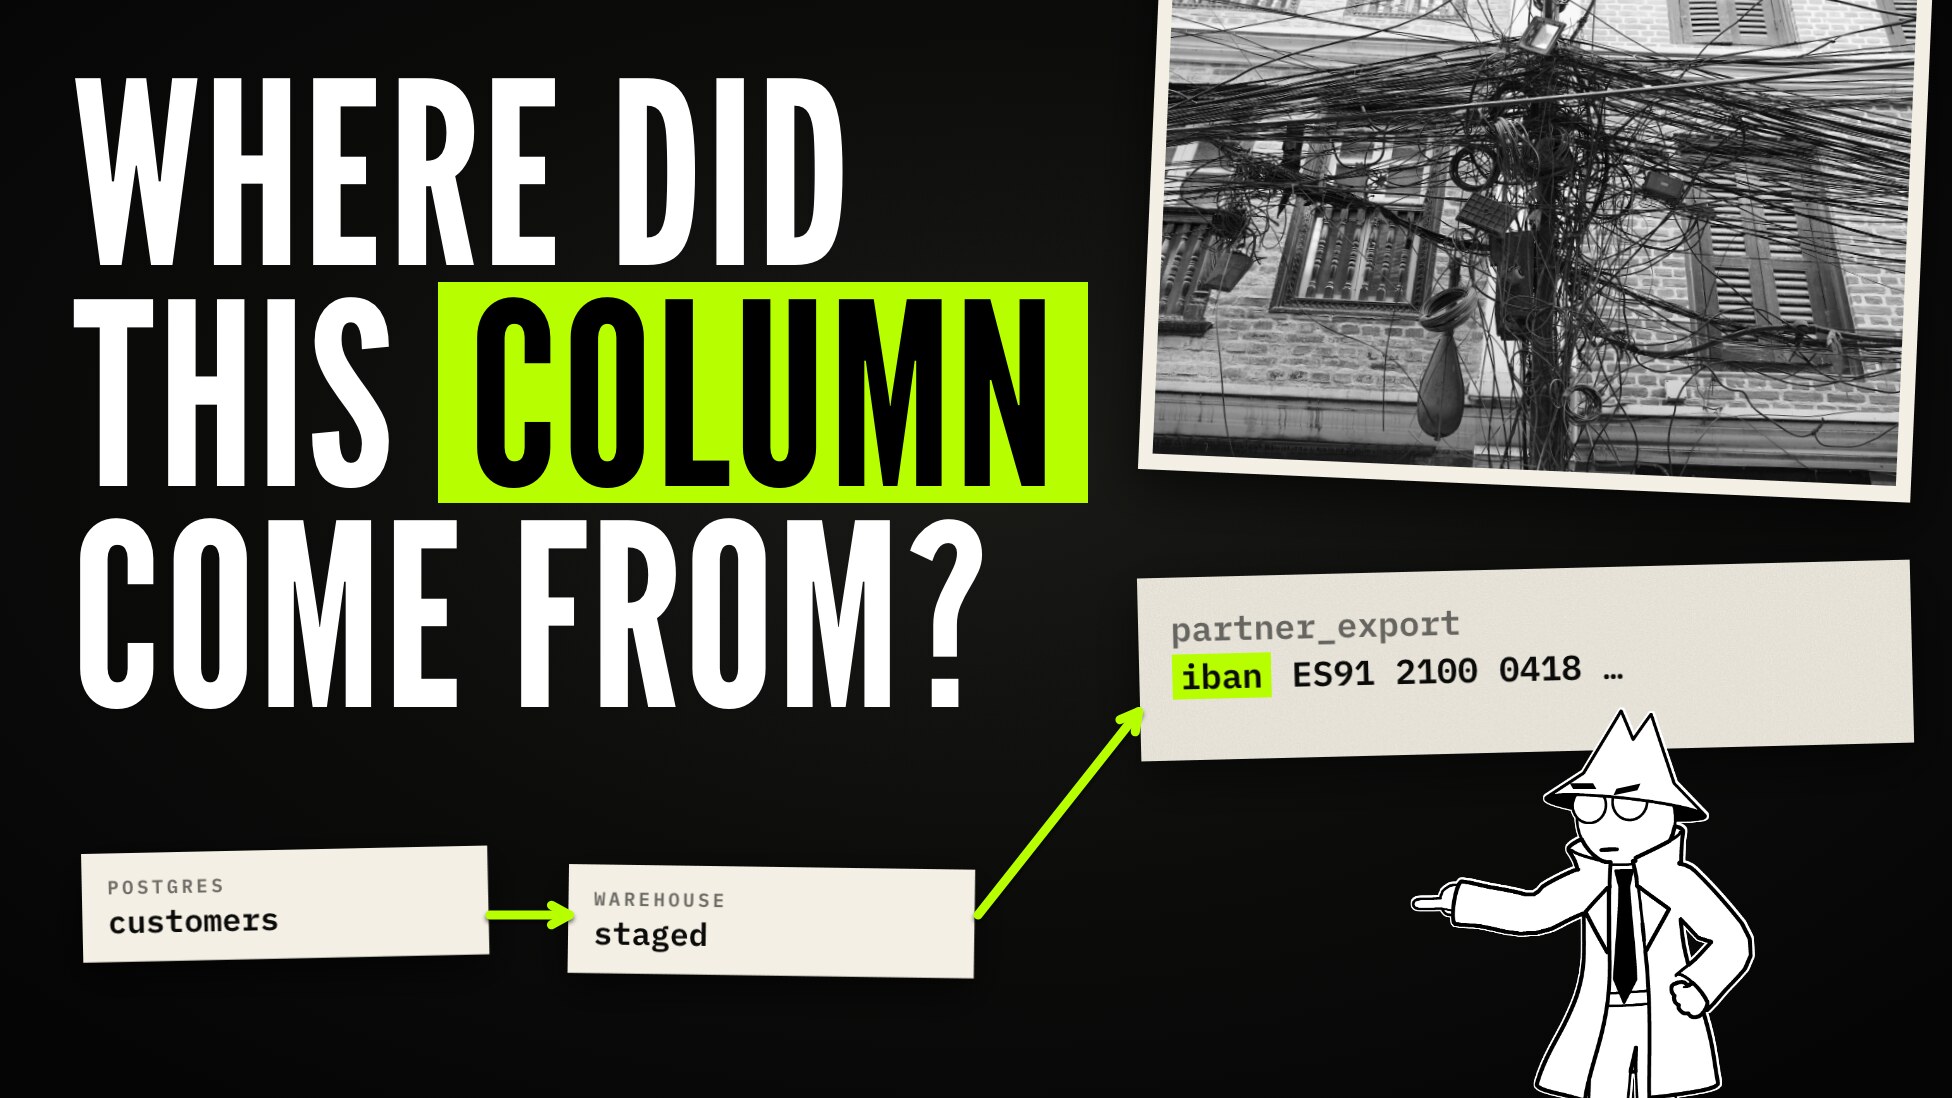
Ein Partner schreibt Ihnen an einem Dienstag. Die wöchentliche Datei, die Sie ihm schicken, enthält die Kontonummern Ihrer Kunden.
Sie brauchen heute zwei Antworten. Woher kommt diese Spalte? Und was bricht, wenn Sie sie entfernen? Niemand im Raum weiß es. Die Datei stammt aus einer Tabelle, die aus einer View stammt, die aus einer Datenbank drei Teams weiter stammt.
Diese zwei Fragen haben einen Namen: Lineage.

Die Menschen, Kontodaten und Zahlen sind erfunden. Die Datenbanken, die Scans und die Lineage sind echt: drei laufende Systeme in einem öffentlichen Test-Arbeitsbereich, am 30. Oktober 2026. Die Bildschirme stammen von dort, außer dem wartenden Pfeil, der vor dem Binden auf einer Testkopie entstand. Die Grafiken stammen von uns, aus einem kurzen Film zu diesem Beitrag.
Stromaufwärts und stromabwärts
Lineage hält fest, woher Werte stammen. Denken Sie an einen Fluss: Stromaufwärts ist, woher das Wasser kommt, stromabwärts alles, was es erreicht.
Ein guter Graph hält sich an eine Regel. Pfeile zeigen in die Richtung, in die die Daten fließen, also steht stromaufwärts links und stromabwärts rechts. Gehen Sie nach innen, erfahren Sie, woher etwas kommt. Gehen Sie nach außen, erfahren Sie, was bricht, wenn es sich ändert.
Warum Lineage-Graphen zu Knäueln werden
Weil alles zu einer einzigen Art von Verbindung plattgedrückt wird. Ein Anhang, ein Fremdschlüssel, eine doppelte Datei und eine aus einer anderen gebaute Tabelle sind vier verschiedene Dinge, und nur eines beantwortet: Was bricht?

Fragen Sie also jede Verbindung nach einem: Haben sich Werte bewegt?
| Klasse | Bedeutet | Beispiel | Ein Schritt im Pfad? |
|---|---|---|---|
| Lineage (Flow) | Die Werte des einen stammen aus dem anderen | Eine View über ihren Tabellen | Ja. Das ist der Lineage-Graph |
| Enthält | Das eine ist Teil des anderen | Ein Diagramm in einem Dashboard | Nein. Es faltet das Bild |
| Dasselbe wie | Ein echtes Ding, zweimal gesehen | Eine Datei in zwei Buckets | Nein. Es führt zwei Knoten zusammen |
| Referenziert | Das eine verweist auf das andere | Ein Fremdschlüssel | Nein. Ein Hinweis, der nichts trägt |
| Genutzt von | Jemand hat es angefasst | Wer eine Datei geöffnet hat | Nein. Ein Gewicht, kein Pfad |
Der Fremdschlüssel überrascht die meisten. Er ist ein guter Hinweis darauf, wo Lineage liegen könnte, aber es wurden keine Daten bewegt, also ist er nie ein Schritt. Was ein System nicht sicher weiß, gehört an denselben Ort: eine Verbindung, die nichts trägt. So bleibt ein Graph lesbar. Die fünf Klassen stehen in der Dokumentation, mit ihrer Bedeutung beim Traversieren.

Welche Art von Bewegung
Innerhalb von Flow sagt die Art der Bewegung, was Sie am anderen Ende erwartet.
- Kopie von. Dieselben Werte, verschoben. Ist die Quelle sensibel, ist es die Kopie auch.
- View von. Eine gespeicherte Abfrage. Sie hält nichts Eigenes, also erreicht sie jede Änderung darunter sofort.
- Abgeleitet. Echte Logik dazwischen. Die Werte können überleben oder nicht, also müssen Sie genauer hinsehen.
- Geschrieben von. Ein Job hat das erzeugt.
- Exportiert nach, gesendet an. Es hat das System verlassen. Dort hört eine Datenschutzfrage auf, intern zu sein.

Spalten-Lineage
Tabellen-Lineage sagt, eine View ist aus zwei Tabellen gebaut. Das stimmt, und es reicht nicht, um zu handeln. Bevor Sie eine Spalte löschen, müssen Sie wissen, ob diese Spalte etwas speist.
Spalten-Lineage hält für jede Ausgabespalte fest, was sie gespeist hat und jede
Funktion auf dem Weg. Das liest sich wie ein Satz: customer ist name, durch
LOWER. income ist amount, durch ein CASE, dann durch eine SUM.
Die Funktionen sind der nützliche Teil, denn sie zeigen, ob das Sensible die Reise überlebt hat. Ein kleingeschriebener Name bleibt ein Name. Eine Summe über viele Zeilen enthält nicht mehr den Betrag einer Person, außer die Gruppe besteht aus einer Person. Jede Zuordnung sagt also eines von dreien: unverändert kopiert, umgeformt oder aggregiert.

Wo und warum
Eine ältere Idee hilft hier. 2001 teilten Datenbankforscher die Frage, woher Daten kommen, in zwei.
- Wo ist der Ort, von dem ein Wert kopiert wurde.
- Warum sind die Daten, wegen derer diese Zeile überhaupt erscheint.

Sehen Sie sich einen Filter an. Ein WHERE country <> 'CH' speist keine
Ausgabespalte und entscheidet doch, wer im Ergebnis steht. Das tut auch ein
Join-Schlüssel. Zeichnete man das als Pfeile in Spalten, schiene jede Spalte von
allem abzuhängen. Darum werden sie getrennt geführt, in einer eigenen Liste:
Spalten, die bestimmt haben, welche Zeilen herauskamen.
Verfolgen Sie einen Wert, können Sie diese Liste überspringen. Löschen Sie eine Spalte, nicht: Entfernen Sie die Filterspalte, bricht die View.

Woher ein Werkzeug das weiß
Die meisten Datenbanken sagen, von welchen Tabellen eine View abhängt, nicht von
welchen Spalten. Also liest ein Werkzeug das SQL der View selbst und folgt jeder
Ausgabespalte zurück: in Common Table Expressions, jeden Zweig eines UNION
entlang, durch Views von Views.
Manche Plattformen melden Spalten aus ihrem eigenen Katalog. Sie nennen die Spalten, nicht die Funktionen dazwischen, die beiden Quellen können also Verschiedenes gut.

Und manchmal ist die ehrliche Antwort: nichts. SELECT * nennt keine Spalten. Eine
nackte Spalte in einem Join könnte zu jeder der beiden Tabellen gehören. Eine
fehlende Antwort schickt Sie nachsehen. Eine selbstsichere falsche schickt Sie in
die Produktion.

Column-Level Lineage behandelt jeden Fall, auch wie man das Panel Zeile für Zeile liest.
Wie weit man einem Pfeil trauen kann
Nicht jeder Pfeil ist gleich sicher, also sollte jeder sagen, woher er bekannt ist.
| Woher bekannt | Bedeutet |
|---|---|
| Zur Laufzeit beobachtet | Etwas hat die Daten fließen sehen |
| Systemkatalog | Die Plattform hat es gesagt |
| SQL gelesen | Aus der Abfrage gelesen |
| Heuristik | Erschlossen. Eine Vermutung, mehr nicht |
| Manuell | Ein Mensch hat es gezeichnet |

Stammt ein Pfeil aus SQL, bleibt das SQL daneben, damit Sie die Herleitung lesen können, statt einem Etikett zu vertrauen.
Über Systemgrenzen
Die wertvollste Lineage überschreitet eine Grenze: zwei Systeme, zwei Scans, manchmal Monate auseinander. Der Trick ist ein Name. Keine ID aus dem Scan, sondern wie die Plattform selbst das Objekt nennt: Host, Datenbank, Schema, Tabelle. Zwei Scanner, die sich nie begegnet sind, schreiben dieselbe Zeichenfolge.

Ein Scan kann also auf eine Tabelle zeigen, die noch niemand gescannt hat. Der Pfeil bleibt und endet an einem umrissenen Knoten: ein Name, in dem nichts steckt. Das ist schon für sich ein Befund, denn er zeigt, wohin Ihre Daten gehen, ohne dass Sie hinsehen.

Schließen Sie dieses System später an, erkennen sich die zwei Hälften. Die Lineage vervollständigt sich selbst, rückwirkend. So sah das echt aus, in einem Test vor und direkt nach dem Hinzufügen eines Schemas zum Scan:


Der Name enthält Host und Port, beide Scanner müssen die Datenbank also auf demselben Weg erreichen. Das wäre uns fast selbst passiert: Eine Verbindung lief über einen Pooler auf Port 6543, die andere über 5432, also hätten beide dieselbe Tabelle verschieden benannt, und der Pfeil hätte sich nie geschlossen. Beide auf denselben Port zu stellen, hat es gelöst.
Eine zweite Aufgabe: Dubletten
Zwei Tabellen sehen fast gleich aus. Die Frage ist nicht, wie ähnlich, sondern warum.
| Was Lineage sagt | Liest sich als | Priorität |
|---|---|---|
| Ein Pfad verbindet sie | Gemeinsamer Ursprung: eine aus der anderen gebaut, oder beide aus einer Quelle | Niedrig |
| Beide haben Lineage, kein Pfad verbindet sie | Kein Pfad: Zwei Teams haben dasselbe gebaut | Der Alarm |
| Eine Seite hat keine Lineage | Lineage unbekannt: eine Lücke, keine Antwort | Werte beurteilen |

Inhalte und Lineage stammen aus verschiedenen Belegen. Genau deshalb sagt ihre Kombination etwas aus. Die Dublettenprüfung baut darauf auf.
Eine echte Spalte
Zurück zur Datei. Dies ist ein Test-Arbeitsbereich mit drei echten Systemen: Postgres, MySQL und ein Databricks-Warehouse. Alles Folgende ist offen: Sie können sich selbst durchklicken.
Der Export enthält fünf Kontonummern, und jede davon taucht in zehn Tabellen auf, über zwei Systeme.
Zehn Verdächtige. Die naheliegende ist eine CRM-Kontaktliste. Eine Wertsuche kann das nicht klären, denn der Wert ist in allen zehn gleich. Lineage kann es.
Gehen Sie stromaufwärts. Der Export liest eine Abrechnung, die Abrechnung liest eine Staging-Tabelle, und dann verlässt der Pfad das Warehouse. Das Warehouse liest die Datenbank über einen Foreign Catalog und meldet den Zugriff, und zwei Scans, die sich nie begegnet sind, schrieben denselben Namen.

Nehmen Sie eine einzelne Spalte. Die IBAN kommt aus customers, in
drei Schritten, und nicht aus der CRM-Liste. Diese Idee ist erledigt.

value_band geht weiter: fünf Schritte, über die Grenze, durch zwei Postgres-Views,
bis zu Menge mal Preis. Lesen Sie die Zeilen. Im Warehouse steht catalog, 95%,
mapped: Es kennt die Verbindung, nicht die Logik. In Postgres steht SQL parsed,
80%, mit den Funktionen.

Gehen Sie nun von dieser Staging-Tabelle abwärts. Eine Abrechnung, ein
Export, sonst nichts. Die Lösung ist eine Spalte in einem SELECT.

Ein Pfeil, den niemand gemeldet hat. Ein nächtlicher Job kopiert Account Manager von MySQL nach Postgres, und keine der Datenbanken weiß davon. Also ist er von Hand gezeichnet, in Bernstein, damit niemand ihn für etwas hält, das eine Plattform gesagt hat.

Ein Pfad, drei Arten von Beleg. Der Fall hält die Urteile fest: die
CRM-Idee widerlegt, customers gestützt, die Lösung bemessen.

Was sie Ihnen nicht sagt
- Nur, was eine Plattform sagt. Gespeicherte Prozeduren, Trigger und externe Jobs hinterlassen keinen Pfeil, solange ihn niemand erklärt.
- Wie Daten fließen können, nicht, dass eine bestimmte Zeile es tat. Ein Pfeil ist eine Aussage über die Struktur.
- Namen müssen passen. Erreichen Sie eine Datenbank über zwei Hostnamen, treffen sich die Hälften nie.
Ein fehlender Pfeil heißt, dass niemand einen gemeldet hat. Er heißt nicht, dass sich nichts bewegt hat.

Wenn Sie wissen, wie Daten fließen, und kein System es sagt, kann ein Custom Connector es erklären, samt Spaltendetail.
Stellen Sie die zwei Fragen einer Spalte, nicht einer Tabelle, und prüfen Sie, woher jeder Pfeil bekannt war.
Selbst öffnen
Alles aus dem Fall ist im Arbeitsbereich all-sources-test live.
| Hier anfangen | Worauf achten |
|---|---|
partner_export | Tab Connections, View, Upstream, ∞: der ganze Pfad. Im Spalten-Panel value_band wählen |
lab_core.customers | Stromabwärts gehen: alles, was sie liest, in beiden Systemen |
lab_hr.employees | Der von Hand gezeichnete Pfeil aus MySQL |
supplier_costs | Der Pfeil, der auf ein Schema wartete und sich selbst band |
| Der Fall | Die Hypothesen, ihre Urteile und die Belege |
Der vollständige Leitfaden steht in der Dokumentation: Lineage & Relationships, Column-Level Lineage und die Quellenseiten zu Databricks, PostgreSQL und MySQL. Fälle behandelt Links on the board.
Mehr aus dem Blog
Tables Made of Files: What a Lakehouse Is and When to Use One
What a data lakehouse is, in plain words. File formats, table formats like Iceberg and Delta, catalogs and engines, when to use one, and why delete is not erase.
Follow the Data: What Lineage Is and How to Read It
A plain-language explainer on data lineage. Why most lineage graphs are unreadable, what flow means, how column lineage works, how far to trust an arrow, how lineage crosses systems, and one real column followed from a warehouse back into a database.