Tabellen aus Dateien: Was ein Lakehouse ist, einfach erklärt
Dateiformat, Tabellenformat, Katalog und Engine: was jeder Teil tut, warum es ihn gibt, wann man überhaupt eines will und was es kostet.
Der Film ist auf Englisch; die deutschen Untertitel sind eingeschaltet.
Eine Kundin schreibt einem kleinen Onlineshop: Bitte löschen Sie meine Daten. Jemand löscht ihre Zeile, und die Kundentabelle antwortet. Elf Kunden. Sie ist weg.
Öffnen Sie jetzt den Bucket, in dem diese Tabelle liegt, und lesen Sie ihre Datendateien. Drei Dateien, einundzwanzig Zeilen. Sie steht noch in einer davon, und neun andere Kunden stehen doppelt drin.
Niemand hat einen Fehler gemacht, und beide Antworten stimmen. Die eine handelt von Dateien, die andere von einer Tabelle. Die Lücke dazwischen ist, was ein Lakehouse ist.

Der Shop, seine Kundschaft und ihre Adressen sind erfunden. Die Dateien, die Iceberg- und Delta-Tabellen und der Scan sind echt: geschrieben in einen S3-kompatiblen Bucket in einem lokalen Testlabor und gelesen am 3. November 2026. Die Zeichnungen sind unsere, aus dem Film oben; wo eine Zeichnung eine Illustration statt einer Messung ist, steht es dabei.
Warum nicht einfach Postgres?
Für eine Anwendung: unbedingt. Eine Datenbank hält die Daten und die Engine, die sie liest, in einer Kiste, und sie ist sehr gut darin, einen Kunden, eine Bestellung, eine Zeile nach der anderen zu bedienen.
Analytik fragt andersherum: eine Spalte, über eine Milliarde Zeilen. Ein Zeilenspeicher hält die Werte einer Zeile auf der Platte zusammen; um eine Spalte zu summieren, liest er jede Zeile ganz. Wächst die Datenmenge über die Kiste hinaus, kauft man eine größere. Und nur diese Datenbank kann ihre eigenen Dateien lesen, also muss jedes andere Werkzeug, ein Notebook, ein BI-Tool, ein Trainingsjob, durch sie hindurch oder bekommt eine Kopie.

Warum nicht einfach ein Bucket?
Also legt man die Daten stattdessen in einen Objektspeicher. Ein Bucket ist billig, wird nie voll, und jedes Werkzeug kann eine Datei darin lesen. Das ist der Data Lake.
Aber ein Bucket kennt nur Dateien. Fragen Sie ihn nach der Kundentabelle, und er kann nicht sagen, welche Dateien das sind. Zwei Jobs schreiben gleichzeitig, und einer überschreibt den anderen. Ein Leser kommt mitten im Schreiben und sieht die Hälfte. Einen Kunden löschen oder eine Spalte umbenennen heißt, Dateien von Hand neu zu schreiben. Wo das endet, hatte bei Teams einen Namen: der Datensumpf.

Die übliche Lösung war eine zweite Kopie, jede Nacht in ein Data Warehouse geladen, für das SQL. Zwei Kopien zu bezahlen, ein Dashboard einen Tag hinterher, ein Format, das nur das Warehouse liest, und maschinelles Lernen, das weiter den Lake las. Dieselbe Zahl kam also aus zwei Quellen, und sie stimmten nicht immer überein.
Was ist ein Data Lakehouse?
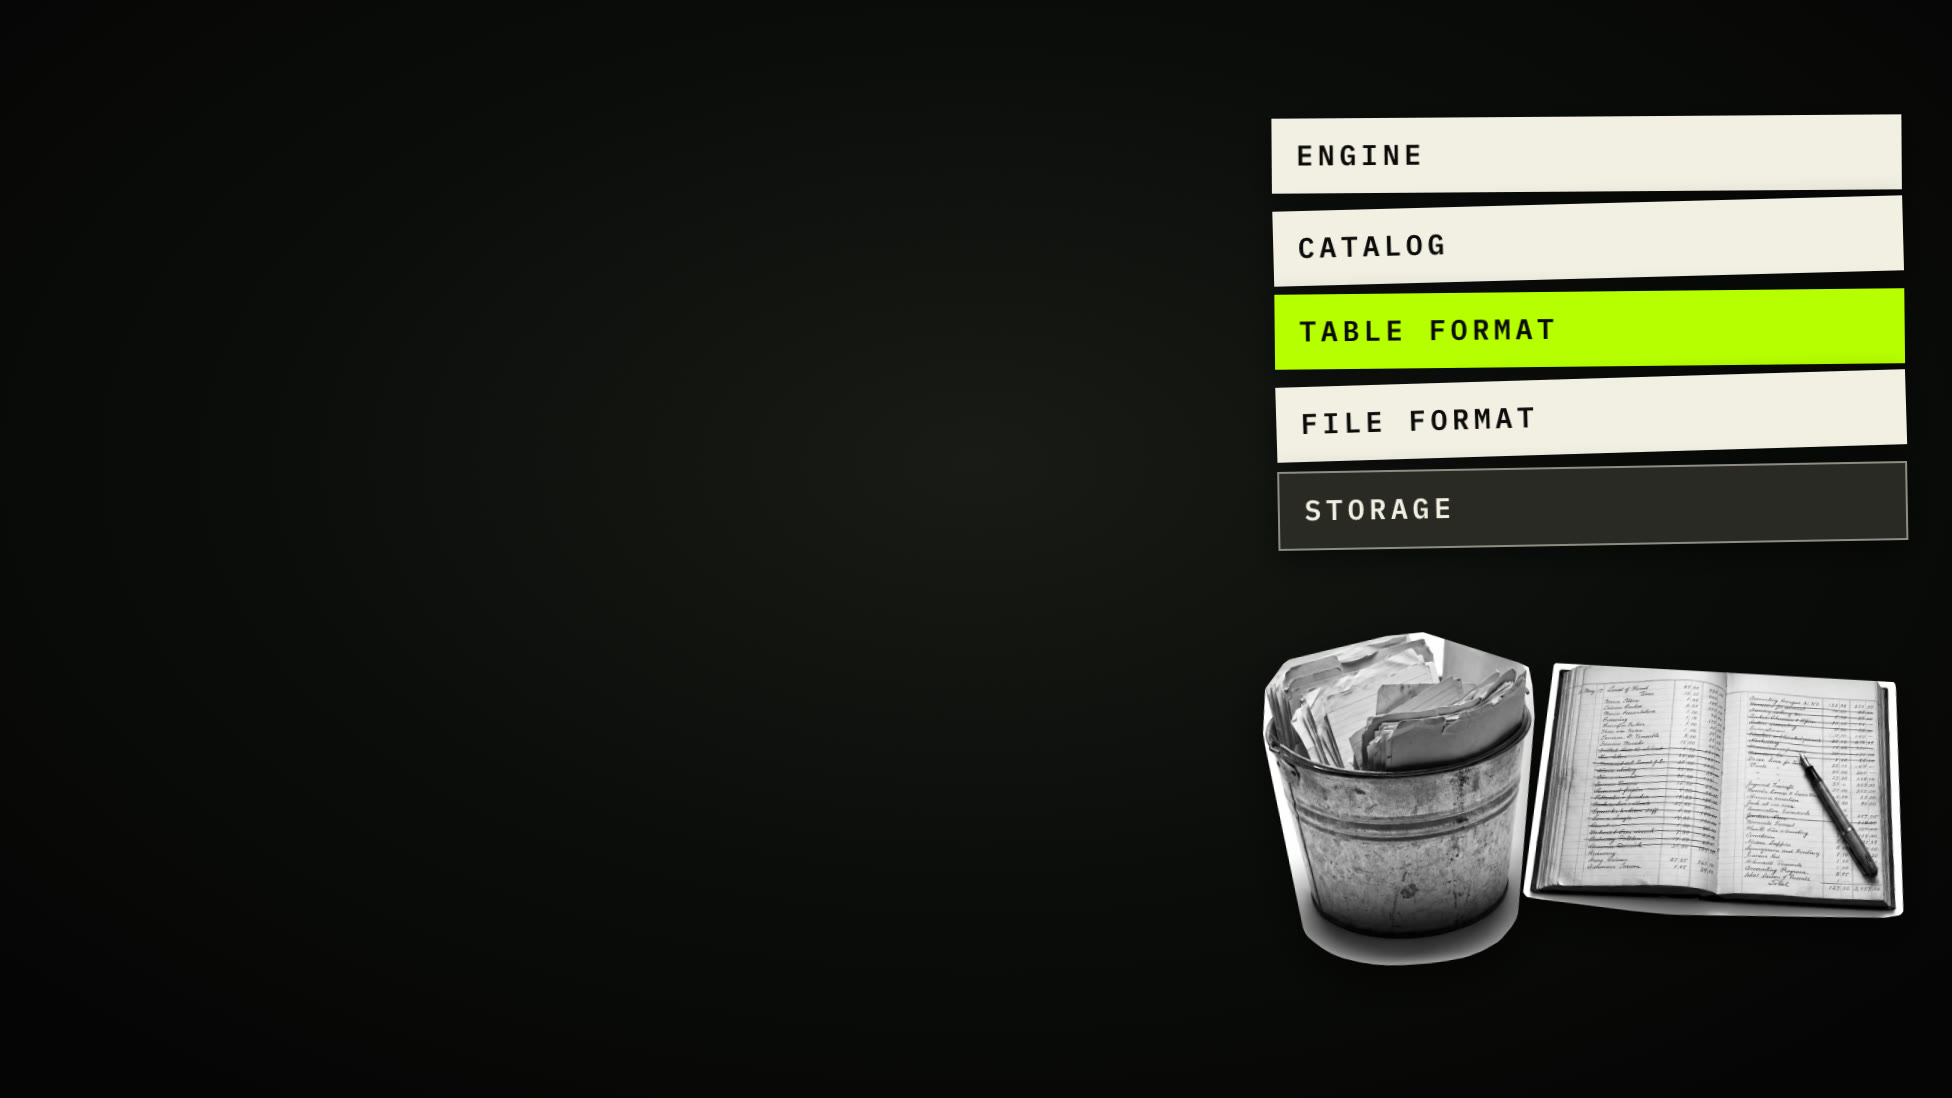
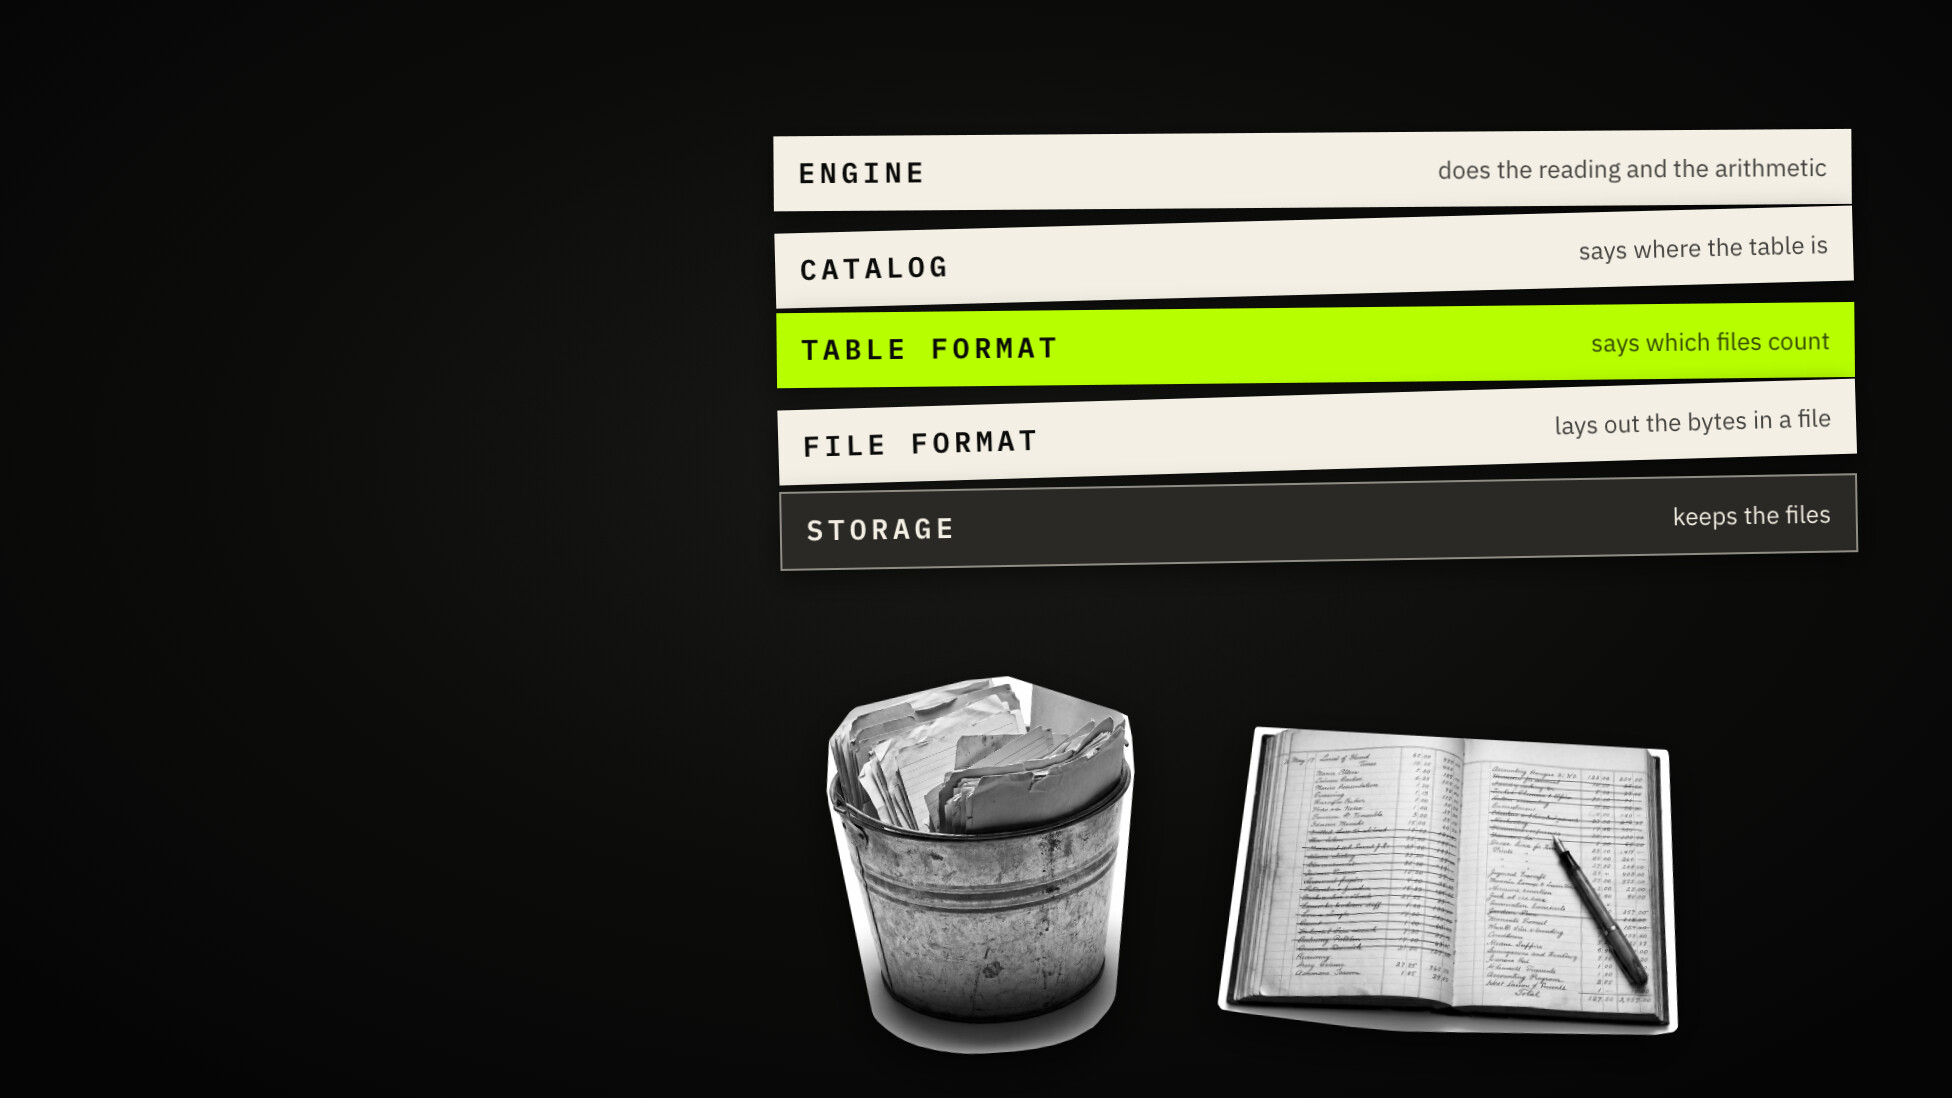
Ein Data Lakehouse behält eine Kopie der Daten: offene Dateien in billigem Speicher. Dann fügt es ein wenig Buchführung hinzu, damit sich ein Ordner voller Dateien wie eine Datenbanktabelle verhält. Der Name stammt aus einem Forschungspapier von 2021; die Teile sind älter. Es sind vier, auf dem Speicher:
| Teil | Was er tut | Beispiele |
|---|---|---|
| Dateiformat | Ordnet die Bytes in einer Datei an | Parquet, ORC, Avro, Lance, CSV, JSON |
| Tabellenformat | Sagt, welche Dateien die Tabelle gerade bilden | Iceberg, Delta Lake, Hudi, Paimon, DuckLake, Lance |
| Katalog | Sagt, wo eine Tabelle ist, unter welchem Namen, und wer sie nutzen darf | Hive Metastore, Polaris, Unity Catalog, Glue, Nessie, Gravitino |
| Engine | Liest und rechnet | Spark, Trino, Flink, DuckDB, die Cloud-Warehouses |

Dateiformate: wie die Bytes liegen
CSV und JSON sind Text, eine Zeile nach der anderen: leicht für Menschen, groß und langsam für Maschinen. Jeder Wert ist eine Zeichenkette, bis etwas ihn deutet.
Parquet (2013) speichert jede Spalte zusammen, komprimiert, und notiert für jeden Block von Zeilen den kleinsten und den größten Wert. Eine Abfrage nach der Oktobersumme liest eine Spalte und überspringt jeden Block, dessen Daten außerhalb des Oktobers liegen. Deshalb liest eine Abfrage über eine große Parquet-Tabelle oft nur einen kleinen Teil davon.

ORC macht dasselbe, aus der Hive-Welt. Avro speichert ganze Zeilen mit ihrem Schema, was zu Nachrichten und Streams passt (Iceberg schreibt seine eigenen Dateilisten in Avro). Lance ist ebenfalls spaltenorientiert, aber schnell beim Holen einzelner Zeilen und Vektoren, und genau das braucht maschinelles Lernen.
| Dateiformat | Aufbau | Gut für |
|---|---|---|
| CSV, JSON | Text, Zeile für Zeile | Austausch mit Menschen und anderen Systemen |
| Parquet | Spalten, komprimiert, Min/Max je Block | Analytik: wenige Spalten über viele Zeilen |
| ORC | Spalten, komprimiert, Indizes | Dasselbe, in der Hive-Welt |
| Avro | Zeilen, Schema in der Datei | Nachrichten, Streams, Metadaten |
| Lance | Spalten, schneller Direktzugriff | Embeddings, Trainingsdaten, Suche |
Trotzdem ist eine Parquet-Datei nur eine Datei. Zehntausend davon sind keine Tabelle.
Tabellenformate: das Hauptbuch
Das ist die Aufgabe des Tabellenformats: ein Hauptbuch neben den Dateien, das festhält, welche Dateien die Tabelle gerade bilden.
Nichts wird an Ort und Stelle geändert. Ein Schreibvorgang fügt neue Dateien hinzu, dann eine neue Version des Hauptbuchs. Leser folgen dem Hauptbuch, also sehen sie die Tabelle vor dem Schreiben oder danach, nie halb. Weil alte Versionen bleiben, können Sie die Tabelle lesen, wie sie am Dienstag war. Eine Umbenennung ist ein Eintrag im Hauptbuch, kein Neuschreiben. Ein Löschen schreibt entweder die eine Datei neu, in der die Zeile steht (Copy-on-Write), oder hinterlässt eine kurze Notiz, dass diese Zeile weg ist (Merge-on-Read: Delete-Dateien, Deletion Vectors).

Unsere Tabelle, zweimal gelesen
Hier ist die Kundentabelle des Shops in ihrem Bucket: drei Datendateien, fünf
Versionen des Hauptbuchs (metadata.json) und die Avro-Listen, die sie
verbinden.
s3://lake/shop/customers/
  data/
    00000-0-4871a10d-….parquet    10 Zeilen, Spalte "email"
    00000-0-93e15aee-….parquet     2 Zeilen, Spalte "contact_email"
    00000-0-2a35b1a0-….parquet     9 Zeilen, ohne Kundin 4
  metadata/
    00000-….metadata.json … 00004-….metadata.json
    snap-….avro (3)   ….avro Manifeste (4)
Lesen Sie den Datenordner als einfache Parquet-Dateien, und Sie bekommen 21
Zeilen, zwei Namen für eine Spalte und die Kundin, die vergessen werden wollte.
Lesen Sie ihn als Tabelle, und Sie bekommen 11 Zeilen, eine Spalte namens
contact_email und keine Spur von ihr. Die Dateien haben sich nie geändert. Das
Hauptbuch ist zu einer Datei ohne sie weitergezogen.

Das ist das Praktischste, was man über ein Lakehouse wissen kann: Ein Werkzeug, das die Dateien statt der Tabelle liest, gibt falsche Antworten. Es zählt gelöschte Zeilen mit, zählt manche Zeilen doppelt und meldet Spalten unter Namen, die die Tabelle nicht mehr verwendet.
Woher die Tabellenformate kommen
Tabellenformate kamen von Teams, die gegen dieselbe Wand liefen.
| Format | Herkunft | Wie es das Hauptbuch führt | Gebaut für | Im Bucket |
|---|---|---|---|---|
| Hive-Tabellen | Facebook, 2008 | Eine Tabelle ist ein Ordner, eine Partition ein Ordner darin | SQL über Dateien | customers/country=NL/… |
| Apache Iceberg | Netflix, 2017 | Ein Baum aus Metadaten über den Datendateien | Korrektheit im großen Maßstab, viele Engines | metadata/*.metadata.json |
| Delta Lake | Databricks, seit 2019 quelloffen | Ein nummeriertes Protokoll der Commits | Spark-Pipelines | _delta_log/00…01.json |
| Apache Hudi | Uber, 2016 | Eine Zeitleiste der Commits | Upserts, nur Geändertes lesen | .hoodie/ |
| Apache Paimon | Flinks Table Store | Snapshots über einem LSM-Baum | Streaming-Änderungen, beim Eintreffen zusammengeführt | snapshot/, schema/ |
| DuckLake | DuckDB Labs, 2025 | Tabellen in einer gewöhnlichen SQL-Datenbank | Einfache Setups, schnelle kleine Commits | die Katalog-Datenbank |
| Lance | Das Lance-Projekt | Eigene versionierte Dateien | Maschinelles Lernen, Vektoren | _versions/*.manifest |
Hives Regel war einfach, und sie brach im großen Maßstab: Millionen Dateien aufzulisten war langsam, und keine Änderung war ganz oder gar nicht. Iceberg wurde bei Netflix gebaut, um genau das zu beheben, und wird heute von den meisten Engines unterstützt. Delta Lake ist mit Spark groß geworden. Hudi entstand bei Uber für Daten, die sich den ganzen Tag ändern. Paimon treibt die Streaming-Idee weiter. DuckLake führt das Hauptbuch in einer Datenbank, die man ohnehin zu betreiben weiß. Lance versioniert seine eigenen Datensätze.

Kataloge: welches Hauptbuch aktuell ist
Eine Tabelle hat viele Versionen ihres Hauptbuchs. Irgendetwas muss sagen, welche
aktuell ist und wie die Tabelle heißt. Der Katalog ordnet einem Namen,
shop.customers, das aktuelle Hauptbuch zu und tauscht diesen Zeiger in einem
Schritt, wenn ein Schreibvorgang abschließt. Dieser Tausch macht einen Commit zu
ganz oder gar nicht. Dort werden auch die Zugriffsrechte vergeben.

Der Hive-Metastore hat das zuerst gemacht. Heute sprechen die meisten Kataloge auch ein offenes Protokoll, Iceberg REST: darunter Apache Polaris, Unity Catalog, AWS Glue, Amazon S3 Tables, Project Nessie, Apache Gravitino, Lakekeeper und der BigLake-Metastore. Eine Engine kann so mit vielen Katalogen arbeiten.
Wählen Sie Ihren mit Bedacht. Die Formate sind jetzt offen. Der Lock-in ist in den Katalog gewandert: Namen, Rechte und Historie liegen dort.
Engines: eine Kopie, viele Leser
Die Engine ist das, was liest und rechnet: Spark, Trino, Flink, DuckDB und die Cloud-Warehouses, die inzwischen auch offene Tabellen lesen. Das ist der Sinn des Ganzen. Eine Kopie der Daten, und jedes Team bringt die Engine mit, die zur Aufgabe passt: Dashboards mit der einen, Training mit der anderen, niemand kopiert.
Wann will man eines?
Eine grobe Regel:
- Passen die Daten auf einen Server und nutzt sie eine Anwendung? Nehmen Sie eine Datenbank. Postgres reicht für Jahre.
- Beantwortet ein Warehouse alles, zu einer Rechnung, die Sie akzeptieren? Bleiben Sie dabei.
- Greifen Sie zum Lakehouse, wenn die Daten einer Maschine entwachsen, wenn mehrere Engines oder Teams dieselben Tabellen brauchen, wenn Berichte und Modelle übereinstimmen müssen oder wenn Ihnen das Format Ihrer Daten selbst gehören soll.
Dann wählen Sie das Tabellenformat danach, wer schreibt:
| Wer schreibt | Format |
|---|---|
| Viele Engines | Iceberg |
| Eine Plattform rund um Spark | Delta Lake |
| Ein steter Strom von Änderungen | Hudi oder Paimon |
| Embeddings und Trainingsdaten | Lance |
| Ein kleines Team, das schon eine Datenbank betreibt | DuckLake |

Was es kostet
- Kleine Dateien. Jeder Schreibvorgang hinterlässt Dateien und Versionen. Ein Streaming-Job, der alle 30 Sekunden committet, macht 2.880 Commits am Tag, und das Lesen wird langsamer, bis jemand die Dateien zusammenführt (Compaction).
- Alte Versionen häufen sich, bis jemand sie ablaufen lässt. Zeitreisen sind nicht umsonst.
- Engines hinken hinterher. Neue Funktionen (Deletion Vectors, neue Typen) kommen unterschiedlich schnell in den Engines an, also schreibt eine vielleicht, was eine andere noch nicht lesen kann.
- Vier Teile, vier Sätze von Einstellungen. Speicher, Format, Katalog und Engine wollen jeweils aktualisiert und beobachtet werden.
- Nichts für die Live-Daten einer Anwendung. Einzelne Zeilen lesen und schreiben gehört in eine Datenbank.
Und der eine Punkt, der für den Datenschutz zählt: Löschen ist nicht Tilgen. Unsere Kundin bleibt im Speicher, bis die Versionen, die auf ihre alte Datei zeigen, ablaufen und die Datei entfernt wird. Nach der DSGVO müssen Sie auf einen Löschantrag innerhalb eines Monats antworten (Art. 12 Abs. 3), also planen Sie es ein:
- Die Zeile löschen. Die Tabelle ist fertig.
- Die alten Versionen ablaufen lassen, die noch auf die alte Datei zeigen.
- Die Dateien entfernen, auf die nichts mehr zeigt (bei Deletion Vectors auch diese bereinigen).
- Die Kopien von vorher finden: Exporte, Backups, Replikate.

Die stillen Kosten sind, zu wissen, was darin steckt. Tabellen verteilen sich über Buckets, Kataloge und Engines, und bald kann niemand mehr sagen, wo die personenbezogenen Daten liegen.
Ein Lakehouse in Classifyre lesen
Das ist die Frage, die Classifyre beantwortet, und es liest ein Lakehouse so, wie eine Engine es tut: über die Tabelle, nicht über die Dateien.
Richten Sie es auf einen Bucket (S3-kompatibel, Azure, Google Cloud Storage oder ein eingehängter Ordner), und es erkennt Delta-, Iceberg-, Hudi-, Paimon- und Lance-Tabellen an ihrem Aufbau und liest jede als eine Tabelle. Oder gehen Sie über einen Iceberg-REST-Katalog oder eine Engine wie Trino, Athena, BigQuery oder Redshift.


Jede Tabelle wird zu einem Asset: ihr Format und ihre Version, der gelesene Snapshot, ihre Spalten und was die Detektoren in ihren aktuellen Zeilen gefunden haben.

Im Bucket des Shops hat es elf Kunden gelesen und ihre elf E-Mail-Adressen gefunden. Nicht die der Kundin, die gelöscht werden wollte. Einmal hat es sie doch noch gefunden: in einem CSV-Export von vor dem Löschen, einer einfachen Datei im selben Bucket und einer Kopie, von der kein Hauptbuch weiß.

Die Ansichten sind Screenshots der laufenden Anwendung in unserem lokalen Testlabor.
Dateien, Tabelle, Katalog, Engine
Dateien halten die Bytes. Das Tabellenformat sagt, welche Bytes zählen. Der Katalog sagt, wo die Tabelle ist. Die Engine macht die Arbeit.
Greifen Sie zum Lakehouse, wenn viele Werkzeuge dieselben Daten brauchen, in einer Größe, die eine Kiste nicht fasst. Und denken Sie daran: Löschen ist nicht Tilgen, bis die alten Dateien weg sind.
Welche Formate auf welchem Speicher und über welche Kataloge und Engines gelesen werden, steht in der Doku: Lakehouse Tables, Iceberg REST Catalog, DuckLake und Trino.
Mehr aus dem Blog
Tables Made of Files: What a Lakehouse Is and When to Use One
What a data lakehouse is, in plain words. File formats, table formats like Iceberg and Delta, catalogs and engines, when to use one, and why delete is not erase.
Follow the Data: What Lineage Is and How to Read It
A plain-language explainer on data lineage. Why most lineage graphs are unreadable, what flow means, how column lineage works, how far to trust an arrow, how lineage crosses systems, and one real column followed from a warehouse back into a database.